一、你改成了"零拷贝",然后内存涨了
做视频管线的人迟早会走到这一步:
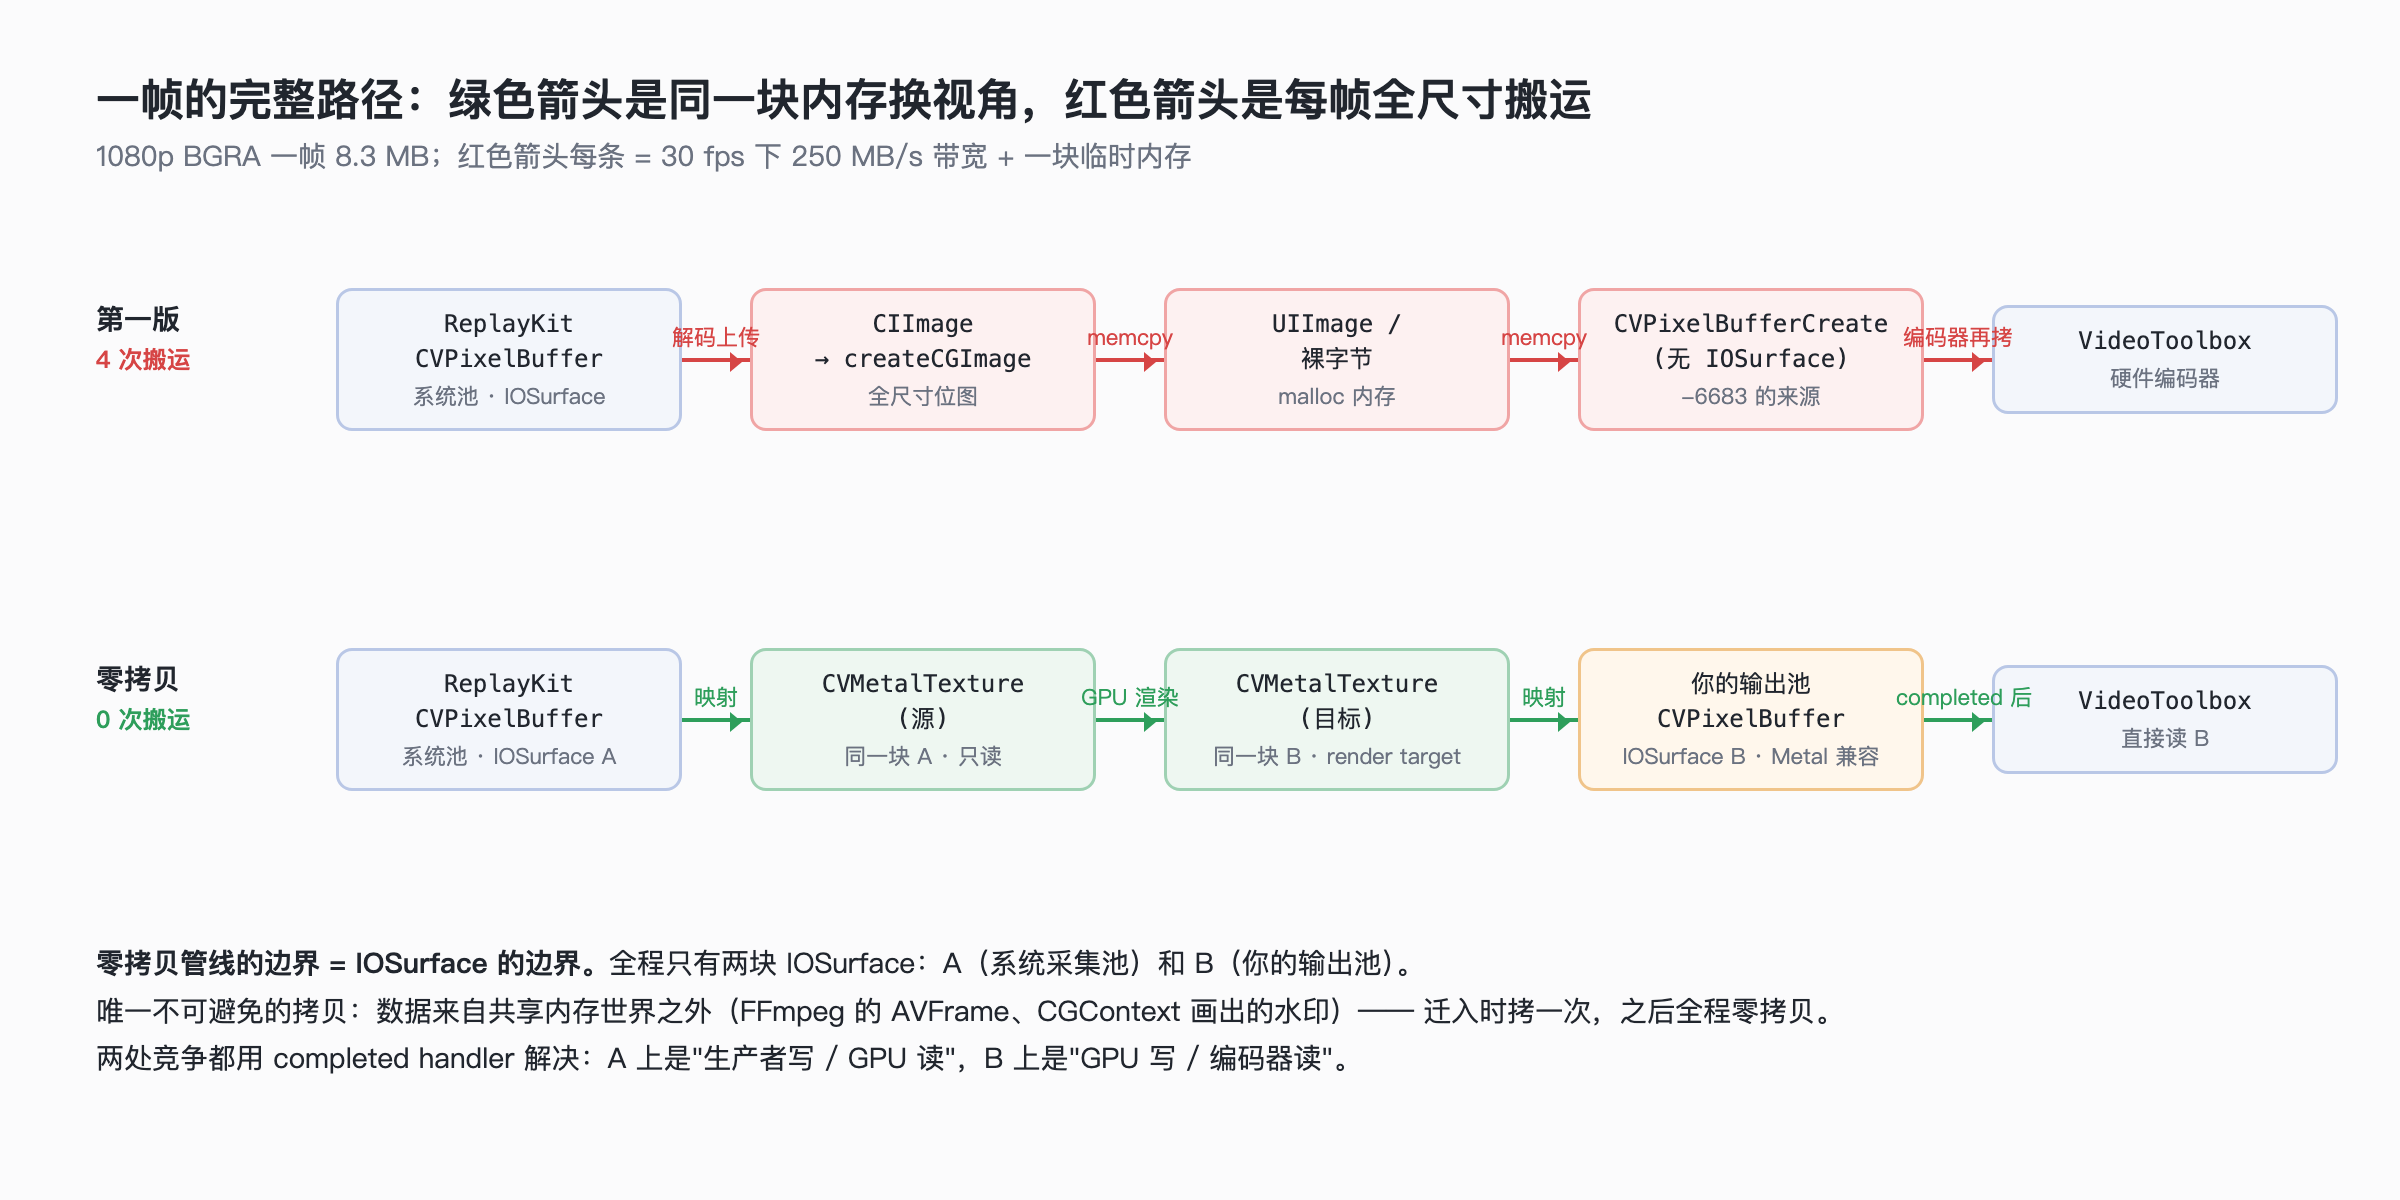
第一版用 CIImage 加水印,createCGImage 出图再塞给编码器。能跑,但 Instruments 里每帧几次全尺寸拷贝,1080p 一帧 BGRA 就是 8MB,一秒 30 帧就是几百 MB 的内存带宽在空转。在 Broadcast Extension 那 50MB 的红线下,这条路直接判死。
于是你查到了"零拷贝":CVPixelBuffer 底层是 IOSurface,用 CVMetalTextureCache 一映射,GPU 直接读,一个字节都不搬。你花一天把管线改过来,memcpy 全部消失,Instruments 里的 allocation 曲线漂亮多了。
然后线上出现三个新问题:
- 内存反而比以前高了,而且随录制时长缓慢上涨,最后被 jetsam 杀掉。
- 偶发画面倒退一帧:某一帧的内容是两帧之前的,或者上半张是这一帧、下半张是下一帧。
- 你自己生成的那张水印图,走同样的映射代码,
CVMetalTextureCacheCreateTextureFromImage返回-6683,而 ReplayKit 送来的帧完全正常。
这三个问题是同一件事的三个侧面:"零拷贝"这个词描述的是数据没动,但它没告诉你,数据没动的代价是"所有权"变复杂了。 拷贝的时候每一份数据只有一个主人,谁分配谁释放,生命周期一目了然。零拷贝之后,一块内存被三个对象引用,各自有各自的生命周期规则,而这三个对象的名字恰好又都长得像"图像",让你以为它们是同一个东西的三种叫法。
它们不是。这篇把三者的关系拆开,然后按踩坑顺序把上面三个问题解释清楚。
二、三个对象,一块内存:谁是真的
先把结论放在前面,后面所有的坑都能回到这张图:
只有 IOSurface 是那块内存本身。CVPixelBuffer 和 MTLTexture 都是它的"视图"——各自带着一套元数据、一套引用计数规则,指向同一块物理页。
IOSurface:内核管的共享内存
IOSurface 是 XNU 内核里的一个对象,本质是一段可以跨进程共享、GPU 和 CPU 都能寻址的内存,附带宽高、像素格式、每行字节数、平面布局这些描述。它有自己的引用计数(跨进程的),还有一个"use count"用来表示"有人正在用它"。
它跨进程这一点是整个系统的基础。ReplayKit 的采集发生在另一个进程里(replayd),编码发生在另一个进程里(VideoToolbox 的硬件编码器在内核 / 协处理器侧),显示合成又在另一个进程里(backboardd / SpringBoard)。一帧画面在这几个进程之间传递而不拷贝,靠的就是传一个 IOSurface 的 ID 而不是传数据。
你在 App 层很少直接碰 IOSurface 的 API,但你碰的每一个 CVPixelBuffer 后面几乎都有一个——注意是"几乎",第四节讲那个例外。
CVPixelBuffer:CoreVideo 给它套的壳
CVPixelBuffer 是 CoreVideo 层的对象,它做三件事:
- 包一个 IOSurface(或者一段普通 malloc 内存,这就是那个例外),对外暴露宽高、格式、平面、
bytesPerRow。 - 挂 attachment:颜色空间、YCbCr 矩阵、range、传输函数。这些 IOSurface 本身不带,全在这一层(颜色那篇讲过,这些 attachment 丢了画面就发灰)。
- 属于一个池(
CVPixelBufferPool):池按CVPixelBuffer这个壳的引用计数来回收。壳的引用归零,池就认为这块内存空闲了,可以发给下一个申请者。
第三点是后面最大那个坑的根源,先记住这句话:池看的是壳的引用计数,不是 IOSurface 的。
MTLTexture:GPU 看这块内存的方式
MTLTexture 是 Metal 的对象。它可以从 IOSurface 直接建:
<span>let</span> desc <span>=</span> <span>MTLTextureDescriptor</span>.texture2DDescriptor(
    pixelFormat: .bgra8Unorm, width: w, height: h, mipmapped: <span>false</span>)
desc.usage <span>=</span> [.shaderRead]
<span>let</span> tex <span>=</span> device.makeTexture(descriptor: desc, iosurface: surface, plane: <span>0</span>)
这一步没有拷贝,只是告诉 GPU"这块内存按这个格式解释"。纹理持有 IOSurface 的引用,所以内存不会在你用的时候被释放——但注意,它持有的是 IOSurface,不是 CVPixelBuffer。这个区别在第五节会变成一个真实的 bug。
CVMetalTextureCache:一个缓存,不是一个新层
CVMetalTextureCache 常被当成"零拷贝的核心 API",其实它只是上面那行 makeTexture(descriptor:iosurface:plane:) 的缓存封装:拿一个 CVPixelBuffer,取出它的 IOSurface,查缓存里有没有已经建好的纹理,没有就建一个存起来。它返回的是 CVMetalTexture,这是又一个壳——它同时持有 CVPixelBuffer 和 MTLTexture。
所以完整的引用关系是:
IOSurface(内存本体,内核对象)
  ▲                 ▲
  │ <span>retain</span>          │ <span>retain</span>
CVPixelBuffer      <span>MTLTexture</span>
  ▲                 ▲
  │ <span>retain</span>          │ <span>retain</span>
  └── CVMetalTexture ┘
        ▲
        │ 缓存持有(直到 Flush)
   CVMetalTextureCache
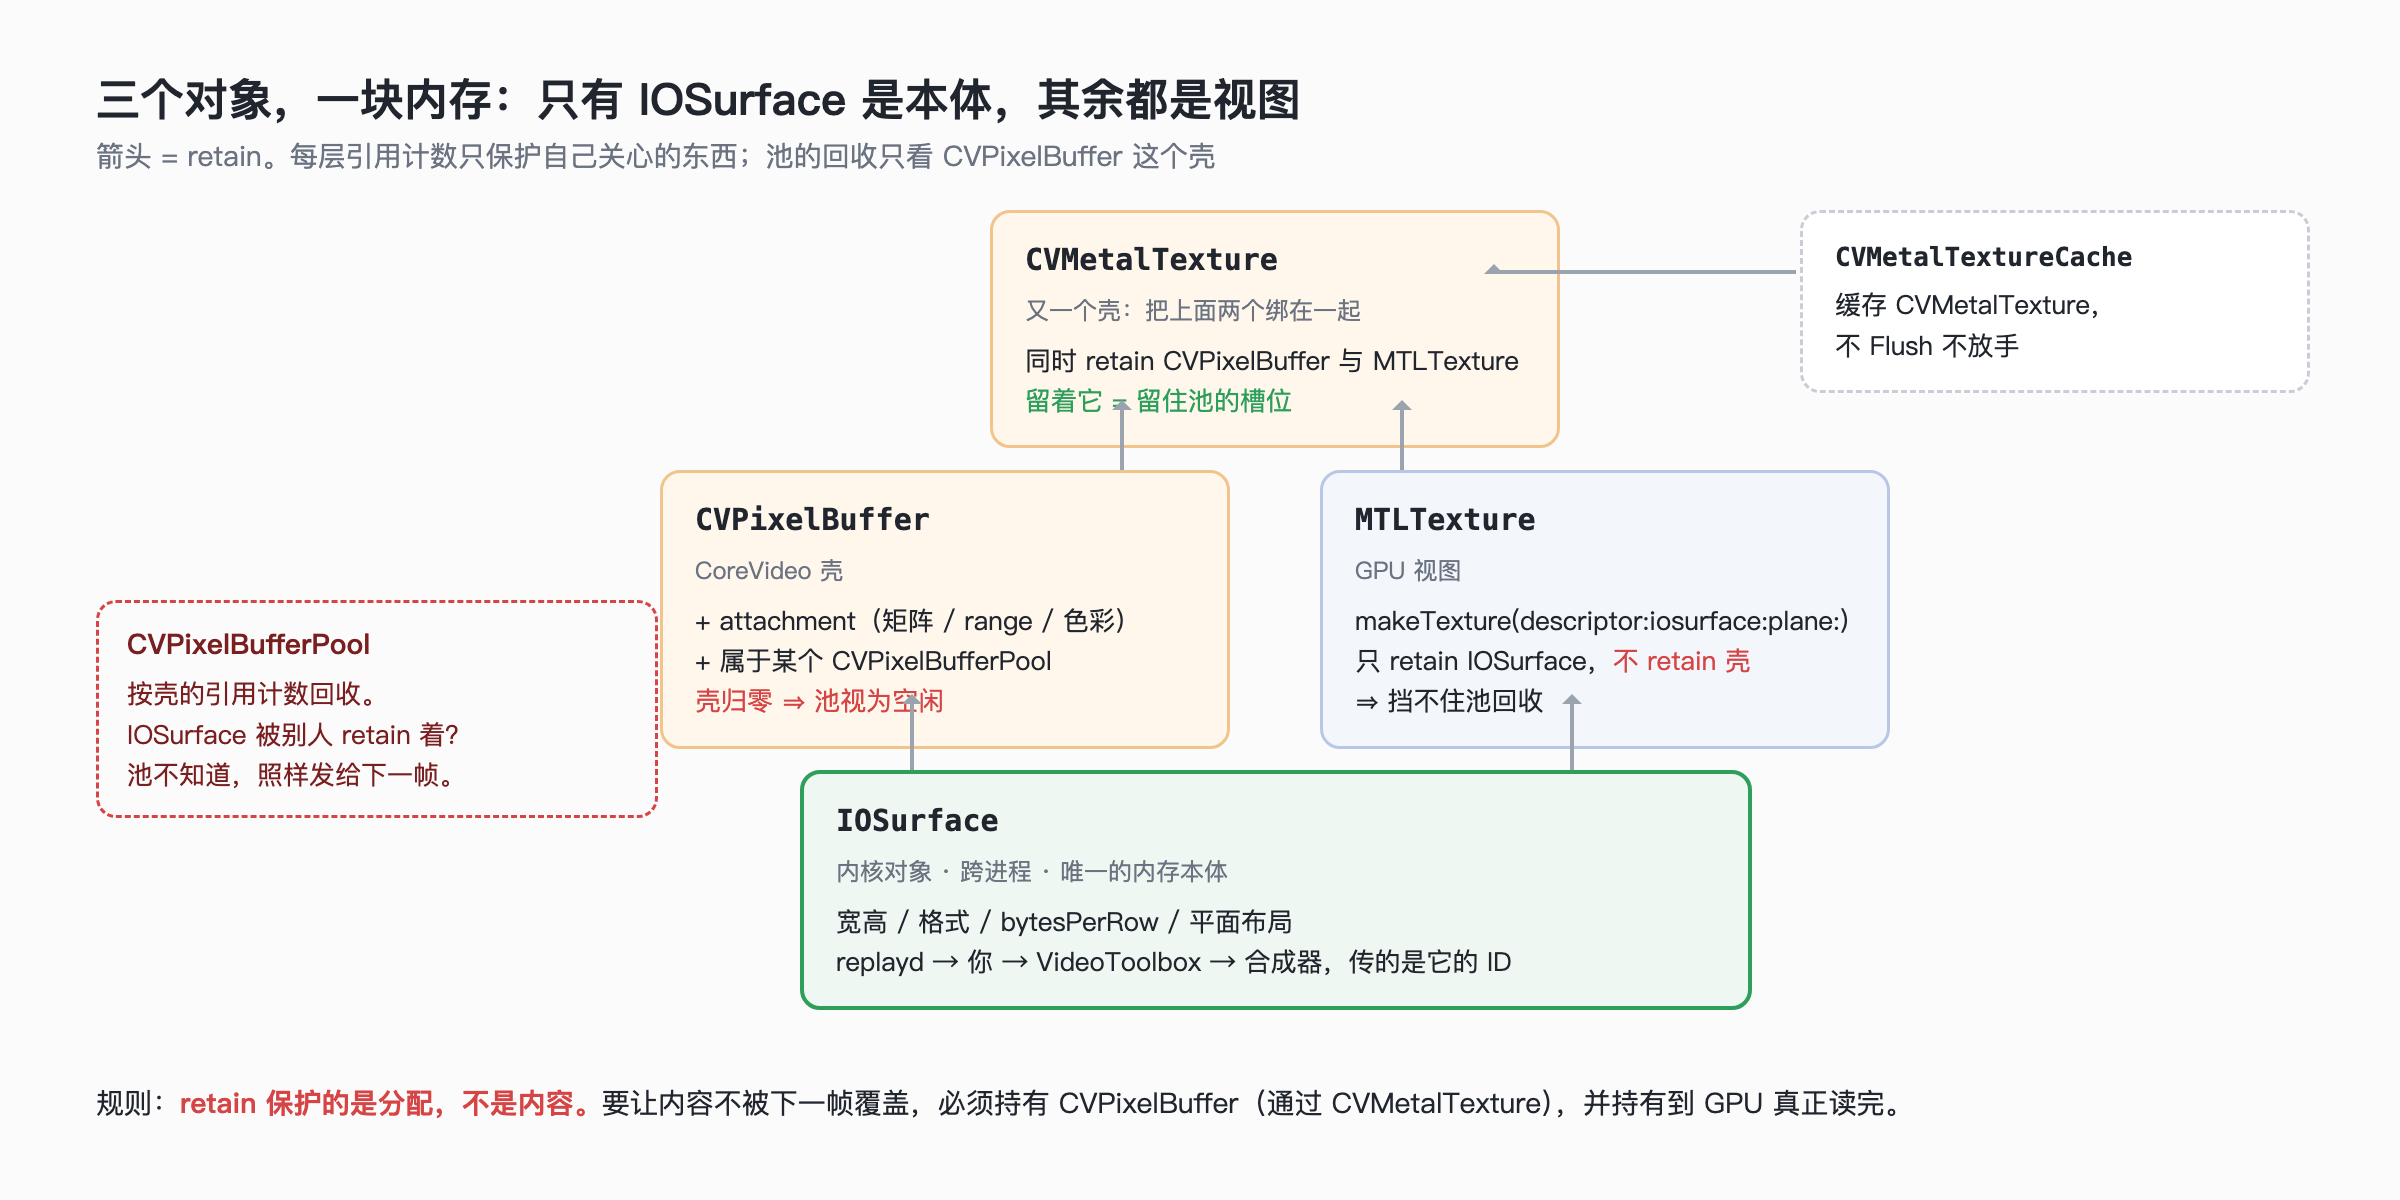
理解这张图之后,"零拷贝"这个词应该翻译成:一块内存,多个句柄,各自的引用计数互不知情。
顺便,算一下账
为什么在录屏场景里这件事这么要紧,把数字摆出来:
<span>1080</span> <span>×</span> <span>1920</span> <span>×</span> <span>4</span> <span>字节</span> <span>(BGRA)</span>           <span>=</span> <span>8.3</span> <span>MB</span> <span>/</span> <span>帧</span>
<span>1080</span> <span>×</span> <span>1920</span> <span>×</span> <span>1.5</span> <span>字节</span> <span>(NV12)</span>         <span>=</span> <span>3.1</span> <span>MB</span> <span>/</span> <span>帧</span>
<span>30</span> <span>fps</span> <span>下,每帧一次全尺寸拷贝</span>          <span>=</span> <span>250</span> <span>MB/s</span> <span>内存带宽(BGRA)</span>
<span>Broadcast</span> <span>Extension</span> <span>内存上限</span>           <span>≈</span> <span>50</span> <span>MB</span>
<span>一帧</span> <span>BGRA</span> <span>在这个预算里的占比</span>           <span>=</span> <span>16</span><span>%</span>
一次拷贝在主 App 里是"性能问题",在 Extension 里是"能不能活"的问题。这就是为什么录屏引擎那篇把"全链路无全帧 CPU 拷贝"列成硬指标。但也正因为这个约束,零拷贝之后新增的那些生命周期问题,在 Extension 里全都会以最坏的形式暴露——内存没有余量给你犯错。
三、坑一:-6683,你自己造的 buffer 不是 IOSurface
先说三个症状里最容易解决的那个。
ReplayKit、AVCaptureVideoDataOutput、VTDecompressionSession 给你的 CVPixelBuffer,全都是 IOSurface 支撑的,因为它们本来就要跨进程。但你自己创建的不一定:
<span>// 这样建出来的 buffer,后面是一段 malloc 内存,没有 IOSurface</span>
<span>var</span> pb: <span>CVPixelBuffer</span>?
<span>CVPixelBufferCreate</span>(<span>nil</span>, w, h, kCVPixelFormatType_32BGRA, <span>nil</span>, <span>&</span>pb)

<span>// 这样建的,永远不可能有 IOSurface —— 内存是你的,CoreVideo 只是借用</span>
<span>CVPixelBufferCreateWithBytes</span>(<span>nil</span>, w, h, kCVPixelFormatType_32BGRA,
                             myPointer, myBytesPerRow, <span>nil</span>, <span>nil</span>, <span>nil</span>, <span>&</span>pb)
拿这种 buffer 去 CVMetalTextureCacheCreateTextureFromImage,返回 kCVReturnPixelBufferNotMetalCompatible(-6683)。不崩,没日志,纹理是 nil。
典型的踩法是水印:用 CGContext 画一张 PNG 到你自己 CVPixelBufferCreate 出来的 buffer,然后走和视频帧一样的映射路径。视频帧全部正常,水印那一路永远 nil,于是你开始怀疑是 PNG 的 alpha、是颜色空间、是线程。
解法是建 buffer 时显式要求 IOSurface + Metal 兼容:
<span>let</span> attrs: [<span>CFString</span>: <span>Any</span>] <span>=</span> [
    kCVPixelBufferIOSurfacePropertiesKey: [:] <span>as</span> <span>CFDictionary</span>,   <span>// 空字典 = "给我一个 IOSurface"</span>
    kCVPixelBufferMetalCompatibilityKey: <span>true</span>,
    kCVPixelBufferPixelFormatTypeKey: kCVPixelFormatType_32BGRA,
    kCVPixelBufferWidthKey: w,
    kCVPixelBufferHeightKey: h,
]
<span>CVPixelBufferCreate</span>(<span>nil</span>, w, h, kCVPixelFormatType_32BGRA, attrs <span>as</span> <span>CFDictionary</span>, <span>&</span>pb)
以及一个便宜的断言,放在管线入口:
<span>@inline</span>(__always)
<span>func</span> <span>assertSurfaceBacked</span>(<span>_</span> <span>pb</span>: <span>CVPixelBuffer</span>, <span>_</span> <span>where</span>: <span>StaticString</span> <span>=</span> <span>#function</span>) {
    <span>assert</span>(<span>CVPixelBufferGetIOSurface</span>(pb) <span>!=</span> <span>nil</span>, <span>"non-IOSurface pixel buffer entered GPU path from <span>\(<span>where</span>)</span>"</span>)
}
CVPixelBufferGetIOSurface 返回 nil 就说明这块 buffer 不在零拷贝的世界里。任何进入 GPU 路径的 buffer 都先过这个断言,能省掉后面所有"为什么这一路是 nil"的排查。
CVPixelBufferCreateWithBytes 没有对应的修法——它的语义就是"用你给的内存",而你 malloc 的内存不可能是 IOSurface。如果你手上只有裸指针(比如 FFmpeg 解出来的 AVFrame),正确路径是从池里申请一个 IOSurface 支撑的 buffer,然后拷一次进去。这一次拷贝是不可避免的:数据来自一个不在共享内存世界里的地方,迁入是要付费的。零拷贝管线的边界,就是 IOSurface 的边界。
四、坑二:画面倒退一帧——retain 保护的是内存,不是内容
这是三个症状里最诡异的一个,也是这篇最值钱的一段。
症状回顾:偶发某一帧的内容是两帧之前的;或者一帧上半是 N、下半是 N+1,像撕裂但不是显示撕裂(录出来的文件里就是这样)。低负载时几乎不出,高负载(4K、60fps、同时开着别的 App)时频繁。
典型的错误写法
<span>func</span> <span>encode</span>(<span>_</span> <span>pixelBuffer</span>: <span>CVPixelBuffer</span>, <span>pts</span>: <span>CMTime</span>) {
    <span>var</span> cvTex: <span>CVMetalTexture</span>?
    <span>CVMetalTextureCacheCreateTextureFromImage</span>(<span>nil</span>, cache, pixelBuffer, <span>nil</span>,
                                              .bgra8Unorm, w, h, <span>0</span>, <span>&</span>cvTex)
    <span>guard</span> <span>let</span> tex <span>=</span> cvTex.flatMap(<span>CVMetalTextureGetTexture</span>) <span>else</span> { <span>return</span> }
    <span>// cvTex 在这里之后不再被引用 —— 只留了 MTLTexture</span>

    <span>let</span> cmd <span>=</span> queue.makeCommandBuffer()<span>!</span>
    renderer.draw(source: tex, into: outputTexture, cmd: cmd)
    cmd.commit()
    <span>// 函数返回。pixelBuffer 的引用归零,回池。</span>
    <span>// 但 cmd 还没执行完,GPU 还没读 tex。</span>
}
看起来没问题:tex 是 MTLTexture,它持有 IOSurface,GPU 用的时候内存肯定还在。确实还在——内存在,内容不在了。
发生了什么
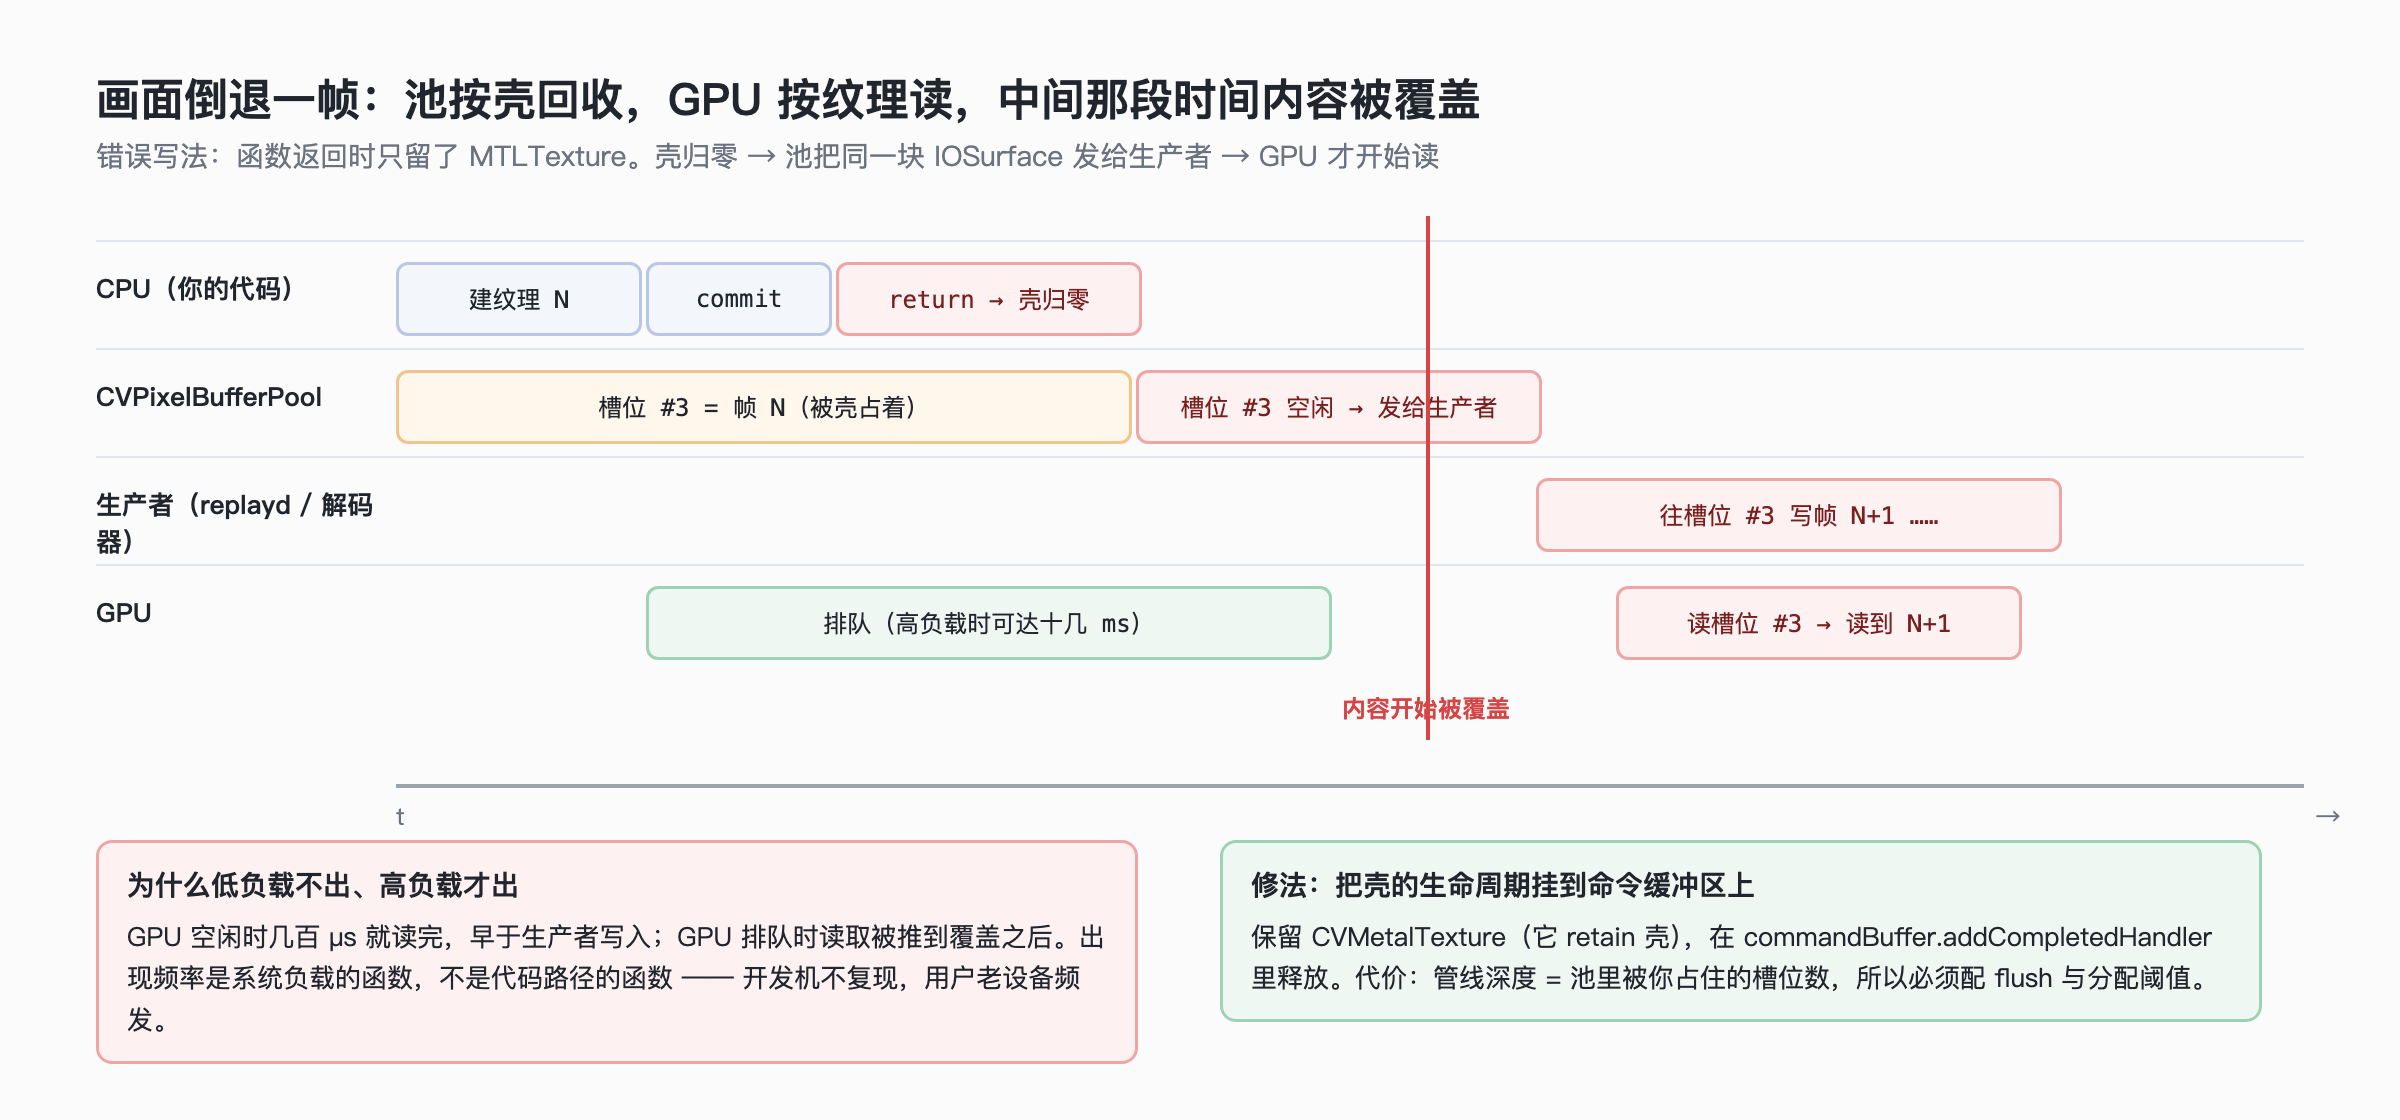
按时间线走一遍:
- 帧 N 的
pixelBuffer从池里来,你建了纹理,提交了命令,函数返回。 pixelBuffer这个壳的引用归零。池只看壳,认为这块 IOSurface 空闲了。MTLTexture还持有 IOSurface 的引用,所以 IOSurface 不会被释放。但池不管这个,池的回收逻辑和 IOSurface 的引用计数是两套账。- 生产者(ReplayKit / 解码器)向池申请下一块 buffer,池把同一块 IOSurface 发出去,生产者开始往里写帧 N+1(或者 N+2)。
- GPU 这时候才真正执行你的命令,从那块 IOSurface 读——读到的是正在被写入的 N+1。
于是"上半 N 下半 N+1"(写了一半)或者"整帧是 N+2"(写完了,你那条命令排得比较靠后)。
retain 保护的是"这块内存不会被释放",不保护"这块内存的内容不会被改写"。 在池化系统里,内容的所有权由池的回收规则决定,而池只认识 CVPixelBuffer 这个壳。
这就是为什么 CVMetalTexture 这个看似多余的壳必须留着:它持有 CVPixelBuffer,CVPixelBuffer 不归零,池就不会回收。
正确写法:把生命周期挂到命令缓冲区上
<span>func</span> <span>encode</span>(<span>_</span> <span>pixelBuffer</span>: <span>CVPixelBuffer</span>, <span>pts</span>: <span>CMTime</span>) {
    <span>var</span> cvTex: <span>CVMetalTexture</span>?
    <span>CVMetalTextureCacheCreateTextureFromImage</span>(<span>nil</span>, cache, pixelBuffer, <span>nil</span>,
                                              .bgra8Unorm, w, h, <span>0</span>, <span>&</span>cvTex)
    <span>guard</span> <span>let</span> holder <span>=</span> cvTex, <span>let</span> tex <span>=</span> <span>CVMetalTextureGetTexture</span>(holder) <span>else</span> { <span>return</span> }

    <span>let</span> cmd <span>=</span> queue.makeCommandBuffer()<span>!</span>
    renderer.draw(source: tex, into: outputTexture, cmd: cmd)

    <span>// 关键:让 GPU 完成之前,holder(→ pixelBuffer → 池的槽位)一直活着</span>
    cmd.addCompletedHandler { <span>_</span> <span>in</span>
        <span>withExtendedLifetime</span>(holder) {}
    }
    cmd.commit()
}
withExtendedLifetime 只是为了让编译器不要把 holder 的捕获优化掉,语义上就是"这个闭包持有它,闭包在 GPU 完成后才释放"。
这样做的直接后果是:你的管线深度决定了池里有几块 buffer 被占着。 GPU 落后 2 帧,就有 2 块 buffer 在你手里。这是零拷贝必须付的账——你不拷贝,就得借着人家的内存用,借多久池就少多久。所以下一节的内存问题,根源也在这里。
为什么低负载不出、高负载才出
低负载时 GPU 很闲,命令提交后几百微秒就执行完了,早于生产者写下一帧。高负载时 GPU 排队,命令可能延迟十几毫秒执行,正好撞上生产者的下一次写入。这个 bug 的出现频率是系统负载的函数,而不是你代码路径的函数,所以它在开发机上几乎不复现,在用户的老设备上频繁出现。凡是"只在老设备 / 高负载下偶发的画面错乱",先查生命周期,再查别的。
五、坑三:内存上涨——你没拷贝,但你在"持有"
现在回到第一个症状:改成零拷贝之后内存反而高了,而且缓慢上涨。
三个来源,按发现的顺序。
来源 A:CVMetalTextureCache 不会自己放手
缓存的语义是"帮你留着,下次复用"。它持有 CVMetalTexture,CVMetalTexture 持有 CVPixelBuffer,CVPixelBuffer 占着池的槽位。你不主动 flush,缓存就一直攥着——而池里的 buffer 是轮转的,缓存会逐渐把池里每一块都碰过一遍并留下引用。
<span>// 每帧渲染完(或者每 N 帧)</span>
<span>CVMetalTextureCacheFlush</span>(cache, <span>0</span>)
Flush 释放的是当前没有被外部引用的缓存项。你在第四节用 completed handler 持有的那些不会被它释放,这正是你要的。
这条是文档写了的,但很多人不调,因为"缓存"这个词让人以为它会自己管理容量。它不会。
来源 B:池在增长
你自己建的输出池(渲染结果写进去,再交给编码器)如果不设上限,CVPixelBufferPoolCreatePixelBuffer 在池空时会新分配一块,而不是等待。GPU 落后、编码器落后,池就一直长。每块 8MB,长几块就过线了。
正确做法是给池设阈值,让它在超限时拒绝而不是分配:
<span>let</span> poolAttrs: [<span>CFString</span>: <span>Any</span>] <span>=</span> [
    kCVPixelBufferPoolMinimumBufferCountKey: <span>3</span>,
]
<span>let</span> bufferAttrs: [<span>CFString</span>: <span>Any</span>] <span>=</span> [
    kCVPixelBufferPixelFormatTypeKey: kCVPixelFormatType_32BGRA,
    kCVPixelBufferWidthKey: w, kCVPixelBufferHeightKey: h,
    kCVPixelBufferIOSurfacePropertiesKey: [:] <span>as</span> <span>CFDictionary</span>,
    kCVPixelBufferMetalCompatibilityKey: <span>true</span>,
]
<span>CVPixelBufferPoolCreate</span>(<span>nil</span>, poolAttrs <span>as</span> <span>CFDictionary</span>, bufferAttrs <span>as</span> <span>CFDictionary</span>, <span>&</span>pool)

<span>// 申请时带阈值:池里在用的超过 6 块就返回 kCVReturnWouldExceedAllocationThreshold</span>
<span>let</span> aux: [<span>CFString</span>: <span>Any</span>] <span>=</span> [kCVPixelBufferPoolAllocationThresholdKey: <span>6</span>]
<span>var</span> out: <span>CVPixelBuffer</span>?
<span>let</span> st <span>=</span> <span>CVPixelBufferPoolCreatePixelBufferWithAuxAttributes</span>(<span>nil</span>, pool, aux <span>as</span> <span>CFDictionary</span>, <span>&</span>out)
<span>if</span> st <span>==</span> kCVReturnWouldExceedAllocationThreshold {
    <span>// 下游没消化完,这一帧丢掉 —— 这是背压,不是错误</span>
    droppedFrames <span>+=</span> <span>1</span>
    <span>return</span>
}
阈值让池变成一个天然的背压阀:下游慢了,申请失败,你丢帧。丢帧在录屏里是可接受的(ReplayKit 本来就是可变帧率),内存越线被杀是不可接受的。这个取舍必须在代码里显式做,不能指望池自己做。
来源 C:IOSurface 的记账你看不全
这一条我不给定论,只说观察。
IOSurface 内存在 Xcode 的内存仪表和 phys_footprint 里的归属规则,取决于是哪个进程创建的、有没有被映射进你的地址空间。你自己建池分配的 IOSurface 全算你的,这没有疑问。ReplayKit 送来的帧,你持有期间会不会计入你的 footprint——我在不同 iOS 版本上看到过不一致的表现,不敢写成规则。
所以在 Extension 里唯一可信的数字是运行时问系统:
<span>let</span> available <span>=</span> os_proc_available_memory() <span>// 距离被杀还有多少字节</span>
每秒采一次,画成曲线。它比任何静态推算都准,而且它是 jetsam 真正看的那个数。当这条曲线在零拷贝改造后反而变陡,先查来源 A 和 B,两个都排除了再怀疑记账。
小结这一节
三个来源的共同点:你没拷贝,但你在持有。 在池化系统里,持有比拷贝贵——拷贝占的是你自己的内存,持有占的是池的槽位,而池的槽位是生产者的命脉。第四节的 completed handler 让持有变得必要,这一节的 flush 和阈值让持有变得有界。两个一起用,才是完整的零拷贝。
六、坑四:画面斜着撕开——bytesPerRow 不等于 width × 4
这个坑不在 GPU 路径上,在你偶尔需要 CPU 读像素的时候(比如取一帧做缩略图、做静止检测)。
<span>CVPixelBufferLockBaseAddress</span>(pb, .readOnly)
<span>let</span> base <span>=</span> <span>CVPixelBufferGetBaseAddress</span>(pb)<span>!</span>
<span>let</span> w <span>=</span> <span>CVPixelBufferGetWidth</span>(pb), h <span>=</span> <span>CVPixelBufferGetHeight</span>(pb)
<span>// 错的:</span>
<span>for</span> y <span>in</span> <span>0</span><span>..<</span>h { <span>let</span> row <span>=</span> base <span>+</span> y <span>*</span> w <span>*</span> <span>4</span>; <span>...</span> }
<span>// 对的:</span>
<span>let</span> stride <span>=</span> <span>CVPixelBufferGetBytesPerRow</span>(pb)
<span>for</span> y <span>in</span> <span>0</span><span>..<</span>h { <span>let</span> row <span>=</span> base <span>+</span> y <span>*</span> stride; <span>...</span> }
<span>CVPixelBufferUnlockBaseAddress</span>(pb, .readOnly)
IOSurface 的每一行是按对齐要求填充的(具体对齐值随设备和格式变,几十字节的量级),所以 bytesPerRow 通常大于 width × bytesPerPixel。用 width × 4 当步长,每一行都少读几个字节,累积下来图像越往下偏得越多——画面斜着撕开,右边一条黑边或者错位。
反直觉的地方是它跟分辨率有关:1920 宽的帧,1920 × 4 = 7680,正好被常见对齐值整除,不填充,代码"对";换到某些竖屏分辨率或者缩放后的奇数宽度,一填充就错。于是同一段代码 1080p 完美、720p 斜了,你会去怀疑缩放算法。
多平面格式(NV12)每个平面各有各的 bytesPerRow,用 CVPixelBufferGetBytesPerRowOfPlane。
顺带说 .readOnly 这个 flag:它不是装饰。带 .readOnly 锁,系统知道你不会写,可以跳过 CPU/GPU 缓存同步的那些工作;不带的话系统要假设你改了内容,做一遍缓存维护。在 GPU 正在读同一块 IOSurface 的时候用非只读锁去碰它,还会引入你在第四节刚解决掉的那种竞争。CPU 只读就一定带 .readOnly。
七、反方向:渲染结果怎么零拷贝地交给编码器
前面讲的都是"读":从 CVPixelBuffer 建纹理给 GPU 读。管线还有另一半,"写":GPU 渲染的结果要交给 VideoToolbox 编码。
第一版通常长这样:
<span>// 错:两次全尺寸拷贝</span>
<span>let</span> outTex <span>=</span> device.makeTexture(descriptor: desc)        <span>// 普通纹理</span>
renderer.draw(into: outTex, cmd: cmd); cmd.commit(); cmd.waitUntilCompleted()
<span>var</span> bytes <span>=</span> [<span>UInt8</span>](repeating: <span>0</span>, count: w <span>*</span> h <span>*</span> <span>4</span>)
outTex.getBytes(<span>&</span>bytes, bytesPerRow: w <span>*</span> <span>4</span>, from: region, mipmapLevel: <span>0</span>)   <span>// 拷贝 1:GPU → CPU</span>
<span>var</span> pb: <span>CVPixelBuffer</span>?
<span>CVPixelBufferCreate</span>(<span>nil</span>, w, h, kCVPixelFormatType_32BGRA, <span>nil</span>, <span>&</span>pb)
<span>// ... memcpy bytes 进 pb                                                      // 拷贝 2:CPU → CoreVideo</span>
<span>VTCompressionSessionEncodeFrame</span>(session, pb<span>!</span>, pts, <span>...</span>)                       <span>// 而且 pb 不是 IOSurface,编码器可能再拷一次</span>
正确路径是反过来:先从池里拿一块 IOSurface 支撑的 CVPixelBuffer,把它映射成纹理,直接当渲染目标。
<span>// 1. 从你的输出池申请(带阈值,见第五节)</span>
<span>var</span> outPB: <span>CVPixelBuffer</span>?
<span>guard</span> <span>CVPixelBufferPoolCreatePixelBufferWithAuxAttributes</span>(<span>nil</span>, outPool, aux, <span>&</span>outPB) <span>==</span> kCVReturnSuccess,
      <span>let</span> outPB <span>else</span> { <span>return</span> }

<span>// 2. 映射成可作为渲染目标的纹理</span>
<span>var</span> cvOut: <span>CVMetalTexture</span>?
<span>CVMetalTextureCacheCreateTextureFromImage</span>(<span>nil</span>, cache, outPB, <span>nil</span>, .bgra8Unorm, w, h, <span>0</span>, <span>&</span>cvOut)
<span>guard</span> <span>let</span> outHolder <span>=</span> cvOut, <span>let</span> outTex <span>=</span> <span>CVMetalTextureGetTexture</span>(outHolder) <span>else</span> { <span>return</span> }

<span>// 3. 渲染进去</span>
<span>let</span> cmd <span>=</span> queue.makeCommandBuffer()<span>!</span>
renderer.draw(source: srcTex, into: outTex, cmd: cmd)

<span>// 4. GPU 完成后再交给编码器 —— 编码器读的就是这块 IOSurface,零拷贝</span>
cmd.addCompletedHandler { <span>_</span> <span>in</span>
    <span>withExtendedLifetime</span>((srcHolder, outHolder)) {}
    <span>VTCompressionSessionEncodeFrame</span>(session, outPB, pts, .invalid, <span>nil</span>, <span>nil</span>, <span>nil</span>)
}
cmd.commit()
几个细节:
- 输出池的 buffer 属性必须带
kCVPixelBufferMetalCompatibilityKey,否则映射出的纹理不能当 render target(usage里没有.renderTarget)。 VTCompressionSessionEncodeFrame内部会 retainoutPB,编码完释放,那时 buffer 才回池。所以你的输出池深度 = 编码器的排队深度 + GPU 的排队深度。第五节的阈值要按这个算。- 在 completed handler 里提交编码,而不是 commit 之后立刻提交。 GPU 没画完就送编码器,编码器读到的是上一帧的残影——这是第四节那个竞争的镜像版本:那边是"生产者写、GPU 读",这边是"GPU 写、编码器读"。
整条管线走通之后,一帧从 ReplayKit 到磁盘,全程只有两块 IOSurface 参与:采集那块(系统的池)和渲染输出那块(你的池)。中间没有任何一次全尺寸搬运。
八、格式对应表:不是所有格式都能零拷贝
CVMetalTextureCacheCreateTextureFromImage 要你自己指定 MTLPixelFormat,指定错了要么返回错误要么采样出乱码。我用的对应关系:
| CVPixelFormat | 平面 | MTLPixelFormat | 说明 |
|---|---|---|---|
| `32BGRA` | 0 | `.bgra8Unorm` | 最省事,但比 NV12 大一倍 |
| `420YpCbCr8BiPlanar{Video,Full}Range` (NV12) | 0 | `.r8Unorm` | Y 平面,全尺寸 |
| 同上 | 1 | `.rg8Unorm` | CbCr 交织,宽高各减半 |
| `420YpCbCr10BiPlanar{Video,Full}Range` | 0 | `.r16Unorm` | 10 位存在 16 位里,高位对齐 |
| 同上 | 1 | `.rg16Unorm` | |
| `24RGB` | — | 无 | Metal 没有 24 位格式,**无法零拷贝** |
| `420YpCbCr8Planar` (I420,三平面) | 0/1/2 | `.r8Unorm` ×3 | 可以,但三张纹理三次采样 |
两个要注意的点:
10 位格式的值域。 x420 把 10 位样本存在 16 位里,是高位对齐的(值域 [0, 65472],不是 [0, 1023])。按 .r16Unorm 采样出来归一化到 [0, 1] 之后,直接当 [0, 1] 用即可,不要再做 /1023 或者 ×64 的换算。做了的话画面整体偏暗或者过曝,而且你会以为是 transfer function 的问题。
Video range 和 Full range 是同一种内存布局。 从 Metal 的角度 420v 和 420f 没有区别,都是 .r8Unorm + .rg8Unorm。区别在 shader 里怎么解释采样值——这就是颜色那篇讲的事。零拷贝只负责把字节原样送到 GPU,字节的意义是另一层的问题。
九、诚实对比:什么时候你不需要管这些
如果你在主 App 里、720p/1080p、30fps、单级处理,用 Core Image 就够了。
<span>let</span> ci <span>=</span> <span>CIImage</span>(cvPixelBuffer: pb)
<span>let</span> out <span>=</span> ci.applyingFilter(<span>...</span>)
ciContext.render(out, to: outputPB)     <span>// outputPB 是 IOSurface 支撑的,这条路内部是零拷贝的</span>
CIContext 用 Metal 后端时,对 IOSurface 支撑的输入输出,内部就是这篇讲的那套映射,Apple 已经把生命周期管好了。你只要不走 createCGImage / UIImage 那条路(那才是拷贝的来源),Core Image 的开销是可接受的。前面第一节那个"第一版",问题不在 Core Image,在 createCGImage。
自己管纹理只在这几种情况下值得:
- 内存红线:Extension 里那 50MB,Core Image 的内部缓存是黑盒,你需要每一字节可归因。
- 多级 GPU 管线:滤镜、转场、合成叠在一起,中间结果要留在 GPU 上传给下一级,Core Image 的中间纹理管理你控制不了。
- 4K / 60fps:这时 Core Image 的调度开销本身开始显著。
三条一条都不占,就别自己写。写了之后第四、五节那些生命周期问题全部变成你的。
十、收尾:三条可以带走的
第一,零拷贝省的不是拷贝,是所有权的简单性。 拷贝之后每份数据一个主人,清清楚楚;零拷贝之后一块内存三个句柄,每个句柄的引用计数只保护自己那一层关心的东西——MTLTexture 保护内存存在,CVPixelBuffer 保护池不回收,CVMetalTexture 把两者绑在一起。你省掉的 memcpy,全部变成了"这个对象要活到什么时候"的判断。做零拷贝改造的时候,先画引用关系图,再删拷贝代码。
第二,在池化系统里,持有比拷贝贵。 拷贝消耗的是你自己的内存,持有消耗的是池的槽位,而池的槽位是生产者的命脉——ReplayKit 停止送帧、解码器阻塞、编码器排队,都是池被握住的表现。所以零拷贝管线的每一处持有都要有界:completed handler 让持有恰好够长,flush 和分配阈值让持有不会更长。
第三,retain 保护的是分配,不是内容。 这是整篇最反直觉的一句。引用计数告诉你"这块内存不会被 free",不告诉你"这块内存的内容不会被改写"。任何复用内存的系统(池、环形缓冲、双缓冲)都有这个性质,而 bug 的表现永远不是崩溃,是数据错位——画面倒退一帧、音频串到下一段、日志里出现半条上一次的记录。看到这种症状,先查谁在复用,再查谁在持有。
回到开头那三个症状。内存上涨是缓存没 flush 加池没上限;画面倒退是只留了 MTLTexture 没留 CVMetalTexture;-6683 是你自己建的 buffer 没要 IOSurface。三个问题,同一张图。
如果你正在排查零拷贝管线的画面错乱,最快的验证方法是在 completed handler 里强行持有所有相关的 CVMetalTexture,看症状是否消失。消失了就是生命周期,没消失再查格式和 stride。
关于本文代码
文中的 Swift 示例用于说明引用关系、API 调用形态和生命周期的挂接位置,未逐行编译验证。直接用于工程需要补全:CVMetalTextureCache 的创建(CVMetalTextureCacheCreate)与所属线程、Renderer 的实际实现、错误码分支、withExtendedLifetime 在闭包捕获下的具体写法、输出池阈值与编码器排队深度的联动、以及多平面格式的双纹理映射(录屏引擎那篇有完整示例)。
文中的数值(每帧字节数、带宽、-6683 错误码、格式对应表)按公开的像素格式定义与 CoreVideo / Metal 头文件给出,可自行复核。IOSurface 的跨进程记账规则、行对齐的具体数值、以及 CVMetalTextureCacheFlush 的释放时机等以实际设备与 iOS 版本为准,文中明确标注了"观察"而非"规则"的部分。
把内存所有权讲透的实用指南,池按壳回收导致内容被覆写一段尤其值得反复读;适合做 ReplayKit、AVCapture 与 Metal 渲染链路的开发者排查零拷贝故障。