在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
阅读完需:约 6 分钟
支持异步多教师服务与张量/数据并行协同调度;在线蒸馏提速3倍且低延迟;离线蒸馏通过预计算输出消除实时服务开销。
适合搜索算法工程师、推荐系统架构师、大模型落地工程师阅读。
训练一个小语言模型(SLM),以改善点击和申请等相关性与互动目标,需要针对每个训练样本查询一个或多个大型教师模型。为这些教师模型提供服务可能会拖慢整个过程。对于 LinkedIn 这种每秒必须处理数十万次查询的排序系统而言,这会成为瓶颈。许多搜索和推荐团队都面临一项共同挑战:难以从基于关键词的系统转向由大语言模型监督的统一排序器。
LinkedIn 使用 SGLang 创建了一个多教师蒸馏框架。该系统可以加载并服务不同规模的教师模型,同时管理张量并行和数据并行配置。训练期间,异步客户端会向教师模型发送请求,处理其输出,并将结果添加到蒸馏损失中。团队将这种方法称为在线多教师蒸馏。通过在多个节点上部署本地教师模型副本,该系统将蒸馏过程提速 3 倍,同时保持较低延迟,从而支持快速迭代。为了减少服务开销并避免重复计算,LinkedIn 又引入了离线多教师蒸馏。在这种模式下,系统会预先计算教师模型的输出,并将其存储在 HDFS 或 NFS 上。随后,训练过程会直接使用这些结果,而不再实时查询教师模型。
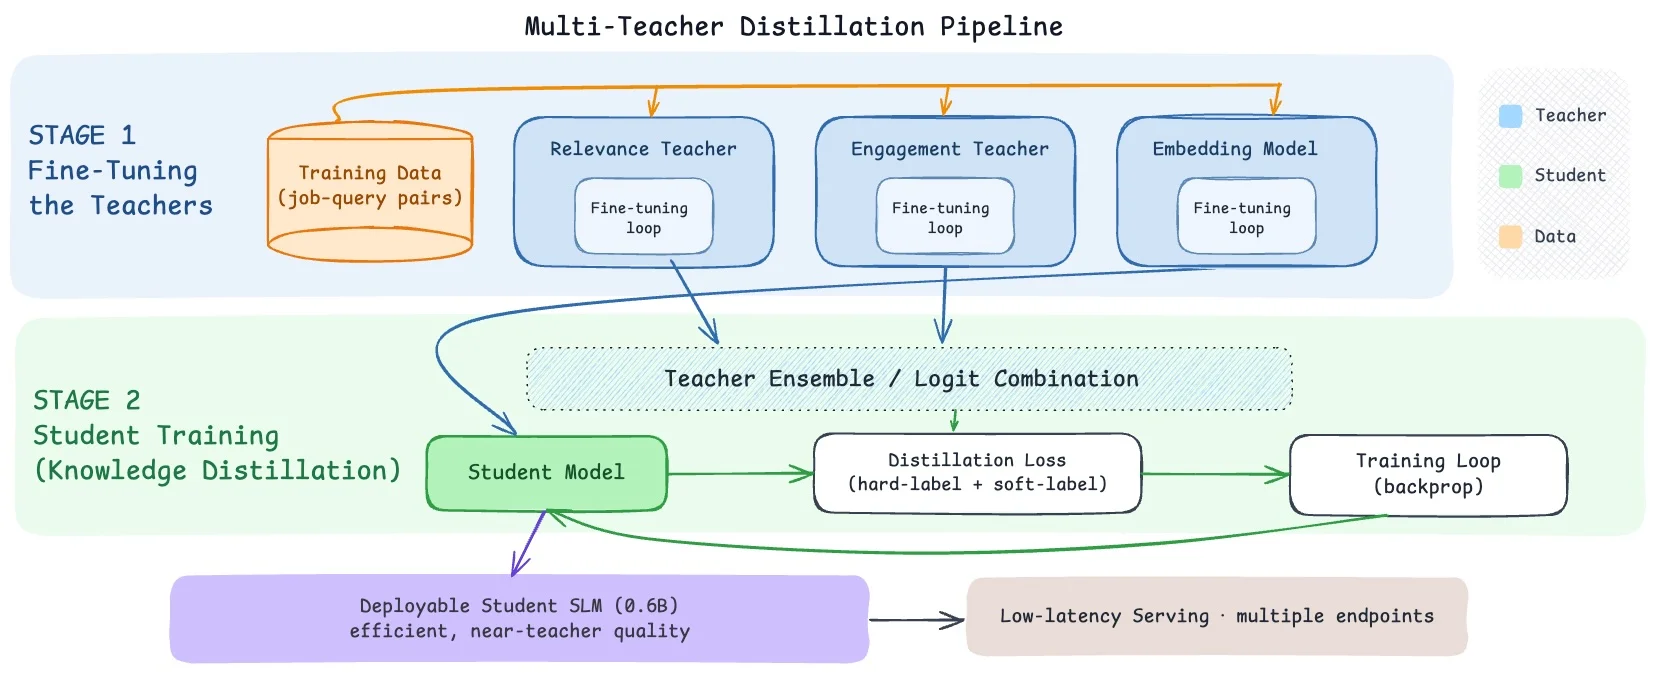
教师模型与学生模型训练的完整流水线
这种在线与离线相结合的方案,还配合了更广泛的训练层优化技术栈:采用 LiGer 降低内存使用量,并将批次大小扩大至原来的 2 倍;通过多节点训练进一步实现最高 3.5 倍的加速;使用 FSDP2 再获得 20% 的性能提升;采用 H200 多节点集群,在此基础上额外提升最高 30%。
团队指出,他们曾评估 FP8 混合精度,但发现它对参数量低于 80 亿的模型没有帮助,因为类型转换开销超过了计算方面的节省。正是这些优化叠加在一起,带来了文章标题中提到的约 8 倍训练速度提升。
在模型方面,LinkedIn 的研究显示,这个 6 亿参数的学生模型改善了职位搜索结果。该模型的知识来自一个 80 亿参数的相关性预言模型和一个 17 亿参数的互动教师模型。它将职位搜索的 NDCG@10 提升了 24.48%,从 0.7583 提高至 0.9432。同一项研究还在推理侧采用了结构化剪枝和上下文压缩,将每块 GPU 的排序吞吐量从每秒约 290 个条目提高到 2000 多个。
该系统已经投入生产,为 LinkedIn 美国用户的自然语言职位搜索提供支持。它基于开源大语言模型服务引擎 SGLang 构建,LinkedIn 此前已在排序工作负载中对其进行投入,而没有使用专有服务技术栈。LinkedIn 将这项工作作为提供给团队的一份指南,帮助其在满足实时延迟要求的同时,实现接近交叉编码器质量的排序,而且无须为每个请求调用前沿大语言模型进行推理,从而避免高昂成本。
构建类似大语言模型监督型排序系统的团队可以采用在线与离线相结合的教师模型服务方案。在教师模型选择仍然频繁变化的早期阶段,可以进行在线查询;当教师模型趋于稳定且查询量增加后,再切换至离线缓存。这些收益来自多项技术的叠加,而不是某一种技巧。LiGer、多节点数据并行、FSDP2 和新一代 GPU 都分别带来了适度提升。此外,对于参数量低于 80 亿的模型,这些优化都不需要使用 FP8。对于考虑默认采用较低精度的团队而言,这一细节非常重要。
2026 年 6 月,Pinterest 发布了一篇相关文章《如何为 Pinterest 基础模型实现近线性的训练扩展能力》。该文章介绍了多节点训练如何帮助构建更大的教师模型,随后再将这些模型的知识蒸馏到效率更高的学生模型中,用于 Homefeed 和 Related Pins 排序。这一过程将实验周期从数周缩短至原来的很小一部分。LinkedIn 的贡献则是创建了一个定制 SGLang 框架,使教师模型能够在训练期间接受实时查询。
Pinterest 侧重于扩展训练框架,并且正在迁移至 Distributed Checkpoint,以支持多节点教师模型训练。最近的一项调查《2026 年蒸馏技术进展:哪些前沿模型正在使用它,又是如何使用的》重点介绍了多教师蒸馏方面的进展。其中包括 NVIDIA Nemotron 3 Ultra、MiMo-V2-Flash 和 DeepSeek-V4,这些模型使用十个或更多专业教师模型进行密集的词元级监督。这种教师模型池的复杂程度超出了 LinkedIn 和 Pinterest 等工业排序系统的需要,后者使用的是数量更少、面向特定任务的教师模型。
原文链接:https://www.infoq.com/news/2026/09/linkedin-ai-multi-teacher/
在线保灵活、离线降开销的取舍务实,8 倍训练提速与 24.48% NDCG 提升值得复用。适合搜索/推荐排序团队参考,教师模型稳定后切离线缓存的建议尤其实用。