谁把美国开源的天花板掀了
Nathan Lambert的基准追踪与'质变'判断
Lambert 在 Threads 上追踪美国开源权重模型数据后给出判断:这周美国开源模型的竞争力发生了 step change。
他没有用模糊词汇。直接说:没有 Muse Spark Open 和 Reflection 的首款 Beam 模型,美国开源权重的格局根本不一样。
Artificial Analysis Intelligence Index 给出的成绩单是 Muse Wonder Full 拿到 56 分,Claude Sonnet 5.5 也是 56 分,GPT-6 Astra 被压在后面。
这不是小幅领先,是跨入同一梯队。
Lambert 的原话是:"这把我等了好久的美国开源权重模型重回 relevant 变成了现实。"
Muse Spark Open为何被定义为'最强美国开源'
Muse Spark Open 的定义来自两个维度。
第一,能力。Muse Spark 系列支持即时、思考、沉思三级推理模式,其中沉思模式接近研究级回答,在科学、健康、数学问题上表现突出。
第二,开源许可。Muse Spark 1.2 权重公开后可商用,这在过去两年 Meta 摇摆于开源与闭源之间时并不确定。
相比之下,美国其他开源模型在基准上仍落后于中国模型。Lambert 提到:今年二月美国模型还明显落后于中国模型,Muse Spark Open 出来后把差距缩短了一半以上。
更准确地说,开源社区终于有了能与闭源头部正面对抗的美国本土底座。
Meta的路线博弈:开源→闭源→重返开源
Meta 这条路线不是一帆风顺的。
Llama 系列曾确立开源生态的事实标准,但在最顶尖能力上,OpenAI、Google DeepMind、Anthropic 的闭源模型长期占据榜单前列。
Meta 一度转向闭源,推出 Muse Spark 首发版本先走商业订阅路线,由重组后的超级智能实验室负责,团队由 Scale AI 创始人 Alexandr Wang 领导。
现在重新开放权重。扎克伯格的原话是:"Muse Spark 是我们的第一代模型家族,Muse Wonder 是更大更先进的类,把我们带到了前沿。"
这不是技术上的临时调整,是商业模式的重新选择。开源权重成了抢占生态的抓手,而不是边缘策略。
开源不是分散式智能的全部
这里要引入一个常被忽略的追问。
截至 2026 年 3 月,Llama 系列累计下载量突破 24 亿次。但下载量高不等于智慧真正分散。
如果数十亿次下载取得的是同一个模型,用户拥有的只是同一套智慧的不同副本,不是各自独立发展的能力。
分析人士把这拆成三个阶段:开源解决分发问题,个人代理推动分化,真正的分散式智慧需要不同 AI 之间协作。
Meta 此次重新开放 Muse Glimmer(30B 参数,可在本地运行)是一个方向参考。
但取得模型和真正拥有属于自己的智慧之间,还隔着训练、工程优化、大规模部署三道门槛。
开源是基础设施,不是终点。
他描述的现象很具体——过去几周美国本土开源权重的竞争力出现了「质变」。这个判断来自基准数据的连续追踪,不是情绪性宣言。
##谁把美国开源的天花板掀了##
开源权重从阵地战变成前沿战
过去两年,开源模型的战场定位很清楚:守住中下游,闭源模型占据前端。
Llama 3.1 405B 出现后,开源阵营在参数规模上追上了闭源模型,但在前沿能力上仍差一档。业界形成了默契——开源做普及,闭源做前沿。
这个默契被打破了。
Muse Spark Open 直接定位为美国最强的本土开源模型。不是「接近」,是「最强」。Muse Wonder Full 在 Artificial Analysis Intelligence Index 上拿到 56 分,与 Claude Sonnet 5.5 持平,压制 GPT-6 Astra。数字摆在这里,没有解释空间。
开源从「追赶者」变成了「定义者之一」。
##开源权重从阵地战变成前沿战过
Llama系列的历史定位:事实标准不等于前沿能力
Llama 系列在开源生态里的地位是事实标准。
截至 2026 年 3 月,Llama 累计下载量突破 24 亿次。这个数字意味着什么?意味着全球开发者的基础设施依赖了 Llama 架构——微调管线、推理框架、部署工具链,围绕 Llama 形成了完整的生态。
但下载量和前沿能力是两件事。
Llama 系列在中游市场的渗透率很高,在顶尖基准上始终落后 OpenAI、Anthropic、Google DeepMind 一档。这是 Meta 过去两年的战略选择:用开源换生态,用生态换护城河。
扎克伯格在 2026 年调整了路线。先闭源再开源,或者边闭源边开源——Muse Spark 是闭源首发,Muse Spark Open 随后开放权重。这不是 Llama 式的「先开源」策略。
事实标准的意义在于:任何进入前沿竞争的新玩家,都必须与 Llama 生态对接。Muse Spark Open 不是替代 Llama,而是在 Llama 建立的生态位上,把能力边界往前推。
Muse Spark Open的参数规模与性能对标策略
Muse Spark Open 的性能对标策略很直接:不躲。
BioTIER 基准上,Muse Spark 的生物武器拒答率达到 98.0%,领先 Opus 4.6(95.4%)、GPT 5.4(74.7%)。这个数字不是训练数据刷出来的——Apollo Research 的第三方评估也确认了安全性边界。
Meta 在 Advanced AI Scaling Framework 下做了大量安全评估。拒答率领先闭源对手,这个数据本身就回答了「开源模型安全吗」的质疑。
参数规模上,Muse Spark 没有公开具体数字。但从「沉思模式」的推理能力来看,这是一个支持多级推理(即时、思考、沉思)的模型。沉思模式提供接近研究级别的回答,这在开源模型里很少见。
更狠的是压缩机制:模型先压缩推理链,再延展解答。不是多生成 token 赌质量,而是训练模型压缩自己的推理过程。
这是 token 效率问题的优雅解法。
压缩推理链,然后延展解答
Reflection Beam模型的协同效应
Nathan Lambert 提到了另一个关键变量:Reflection 的首款 Beam 模型。
Beam 的加入改变了美国开源权重的格局。不是单一模型的能力突破,而是两个模型形成了协同——Muse Spark Open 负责开源前沿,Beam 填补反射性推理的空缺。
没有这两张牌,美国开源权重的竞争力根本不一样。
Reflection 的定位是「反思式推理」——模型在输出前自我审查、自我修正。这和 Muse Spark 的「沉思模式」形成互补:一个强调外部输出质量,一个强调内部推理过程。
开源阵营从「单一模型竞争」变成了「模型组合竞争」。
这才是真正改变游戏规则的点。闭源模型的能力优势在于整合——OpenAI 把推理、工具调用、记忆管理打包在一个系统里。开源阵营过去只能模仿单点能力,现在有了组合的可能性。
开源不是分散式智能的全部。24 亿次下载仍然是同一套权重的副本,不是独立发展的智慧。但 Muse Spark Open 和 Beam 的组合,让「开源前沿」从一个口号变成了一个可验证的事实。
Meta 的路线博弈从「开源换生态」变成了「开源定义前沿」。闭源仍然领先,但领先的定义权不再单一。
这才是这场质变的真正含义。
2026 年初,美国开源权重在多项基准上落后于中国模型。到了 10 月,Muse Spark Open 和 Reflection Beam 同时出现,情况完全反转。Lambert 的原话是:这两个模型把差距缩短了一半以上,时间成本相当于三个月。更准确地说,Muse Spark Open 拿下了「最强美国开源模型」的位置,Reflection Beam 作为第二款参战模型,补上了生态多样性的缺口。没有 Muse Spark Open 和 Beam 这两张牌,美国开源权重的格局根本不一样。
Meta路线摇摆背后的真实动机
闭源订阅制的营收压力与'超级智能实验室'转型
Meta 的路线转变有一个最直接的驱动力。Llama 系列是开源的,开源本身不产生订阅收入。2026 年 Meta 把前沿模型研发交给重组后的「超级智能实验室」,由 Scale AI 创始人 Alexandr Wang 领导。这一人事安排说明方向:前沿模型要变成可以定价的商品。
Muse Spark 首发版本是闭源的,提供即时、思考和沉思三种推理模式。沉思模式接近研究级回答,在科学和健康问题上表现突出,编程方面相对较弱。更关键的是架构转变——Muse 不只是回答问题,它被设计为能在自己的隔离云环境中使用浏览器、内存和工具来完成实际任务:订票、发邮件、填表格。这代表大模型从「生成式」到「代理式」的根本转变。闭源旗舰负责赚钱,开源版本负责生态。
Muse Wonder与Muse Spark的双线布局
Muse Wonder Full 在 Artificial Analysis Intelligence Index 中拿下 56 分,与 Claude Sonnet 5.5 持平,压制 GPT-6 Astra。这是闭源端的火力展示,目的是告诉市场 Meta 依然站在前沿。
开源端的 Muse Spark Open 则在另一个维度竞争。它的对手是同样开源的 Reflection Beam 和其他美国开源权重,不是 GPT 或 Claude。两款产品共享训练底座,但推理路径和商业化模式完全不同。闭源端走 API 调用和 Meta 内部应用(Instagram、Facebook、WhatsApp 的购物助手),开源端走 Hugging Face 下载和自建推理管线。
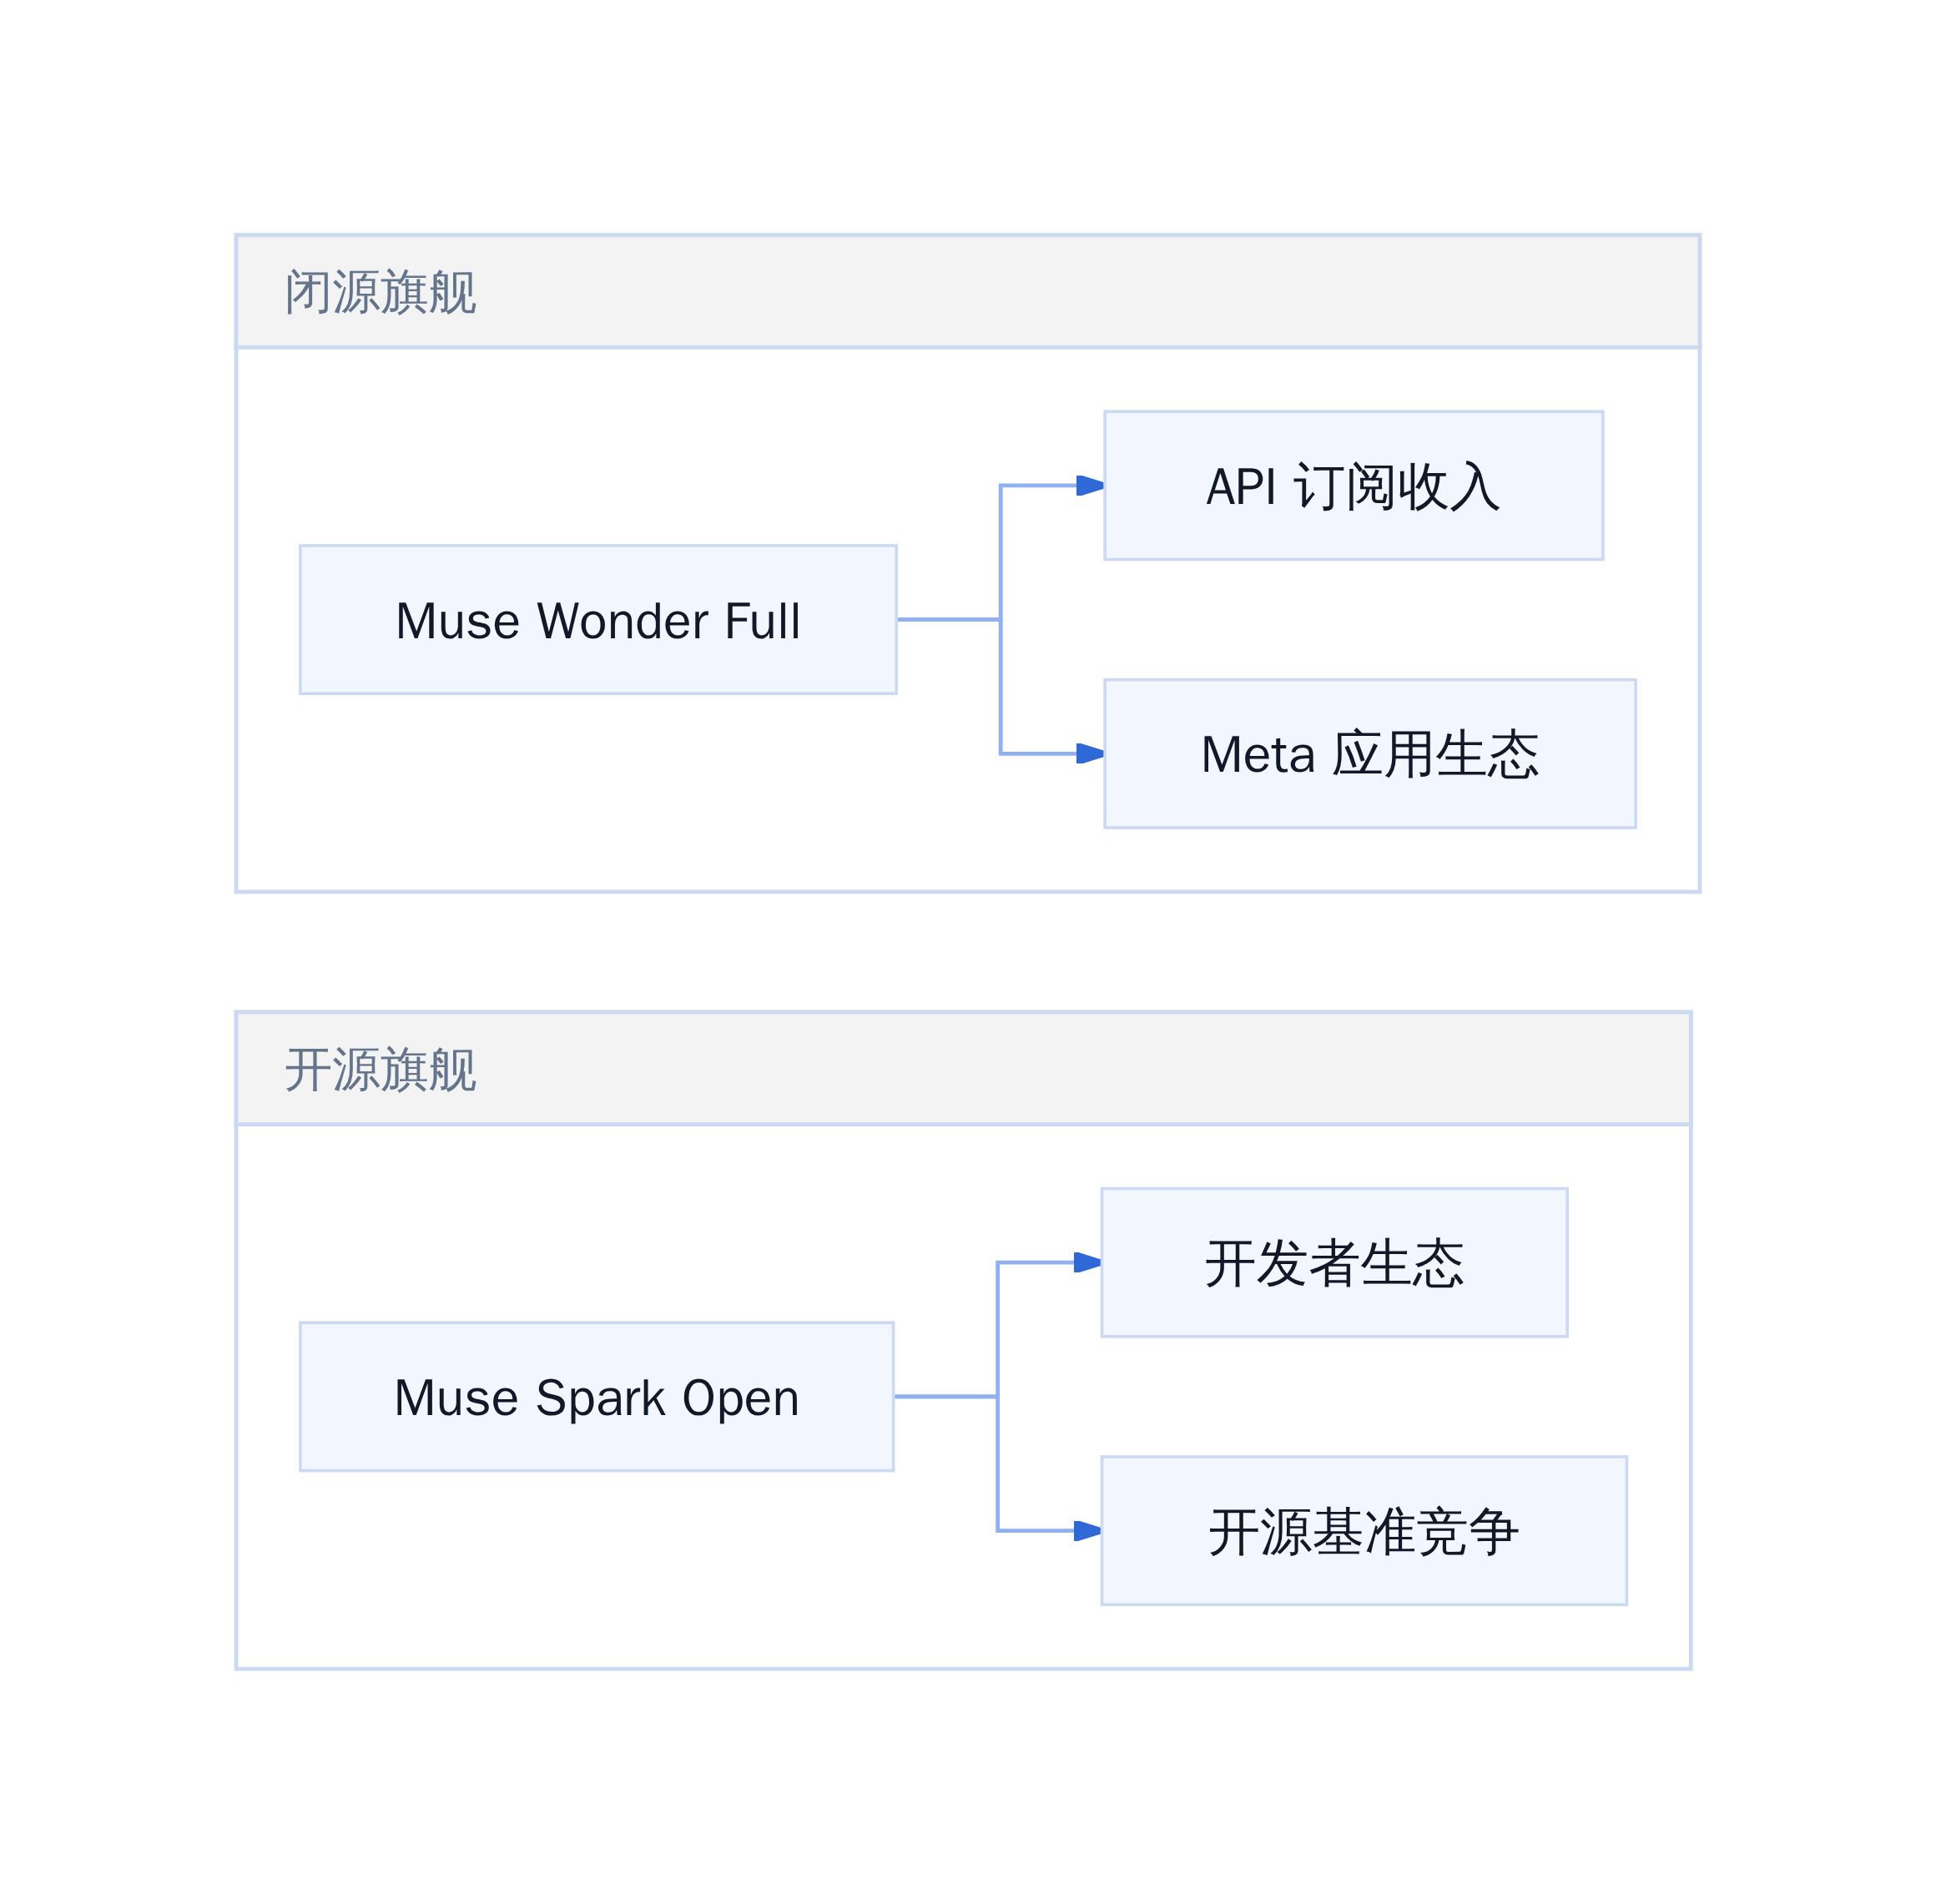
Meta Muse 双线布局策略
一边卖钥匙,一边留副本——Meta 在这道题上的算盘比任何开源宣言都清楚。
从'开源开放'到'可控开放'
Llama 时代 Meta 讲的是「开放就是力量」,Muse 时代 Meta 讲的是「开放要有边界」。当一个公司开始为自己的模型定价,它就需要控制谁能用、怎么用、用在什么地方。完全开源意味着任何公司都可以拿走权重做竞品,这对正在追赶 OpenAI 和 Anthropic 的 Meta 来说风险太高。可控开放的策略是:放出够用但不算顶尖的版本,保留最核心的能力在闭源端。
安全评估也是可控开放的一部分。Muse Spark 在 BioTIER 基准上的生物武器拒答率达到 98%,在所有测试模型中最高,领先 Opus 4.6(95.4%)和 GPT 5.4(74.7%)。Meta 把这作为论据:开放权重的同时要守住安全边界。
Muse Spark Open 的定位就是「美国最强开源」,不是全能冠军。这个定位精确地卡在开源社区最需要、但闭源阵营还没完全覆盖的区间。
但这道题还有后半段。扎克伯格重提去中心化 AI 时说的一个细节被很多人忽略:「开源只是第一步。」开源解决的是分发问题——让模型权重可以被拿到。但拿到权重不等于拥有智慧。如果数十亿次下载取得的是同一个模型的副本,那不是分散式智能,那是复制式智能。
开源不是分散式智能的全部,下载24亿次不等于智慧真正分散。真正的分散需要三个条件同时满足:模型能本地运行、能根据个体数据微调、能在多个代理之间协作。Muse Spark Open 参数规模适中,能在消费级高配硬件上运行,这是条件之一。条件二和三,取决于社区能否在开源权重之上做出真正差异化的微调和应用。Meta 给出了权重,剩下的事交给开源社区自己。
开源模型的工程门槛仍然在
开源权重的竞争力回到前沿,是一回事;把这些权重变成能跑在生产环境里的系统,是另一回事。
Muse Spark Open 的参数规模没有公开到能直接算清硬件成本的级别,但扎克伯格明确点出的另一个数字——30B 参数的 Muse Glimmer——给出了一个可参考的下限。30B 权重本身不贵,加载进显存、跑通推理、支撑稳定的低延迟响应,是另一笔账。
30B参数本地运行的硬件成本
30B 参数模型以 BF16 精度运行,权重占用约 60GB 显存。消费级高端卡里,单张 RTX 4090 是 24GB,需要两张以上做推理加速,或者上 H100/A100 这种企业卡。更现实的选择是用量化方案:INT8 压到约 30GB,INT4 压到约 15GB,但量化后的基准分通常会有 3%–8% 的回落,具体取决于模型结构和任务类型。
本地部署的实际成本不只是显存。还要考虑:
- KV Cache 的显存占用(长上下文场景下可能翻倍)
- 推理框架的调度开销(vLLM、SGLang 各有一套隐性成本)
- 多并发请求下的排队延迟
坦白讲,企业端要跑一个能支持多个用户同时交互的 30B 本地模型,最低配置也是一张 A100 80GB 起,加上推理加速优化,单机成本在 3–5 万美元量级。这不是「下载了权重就能用」的问题。

本地部署一张 A100 的成本,比下载量更难算
开源社区里常见的一种误解是把「能跑起来」等同于「能在生产里用」。Muse Glimmer 30B 确实在消费级高端显卡上可以运行,但这和把它部署到产品里是两个阶段,中间隔着工程优化的大段空白。
推理效率与压缩-延展架构的突破
Muse Spark 的多级推理能力(Instant / Thinking / Contemplating)对应着不同的 token 预算。
更关键的是 Meta 在处理长推理模型 token 效率问题上的设计思路:先压缩,再延展。Eigent 的技术分析指出,模型先在压缩阶段形成高效的推理基线,再在此基础上延展解答以获得更强性能。这不是简单地增加 token 数量然后期待质量随之提升,而是训练模型学会压缩自己的推理链。
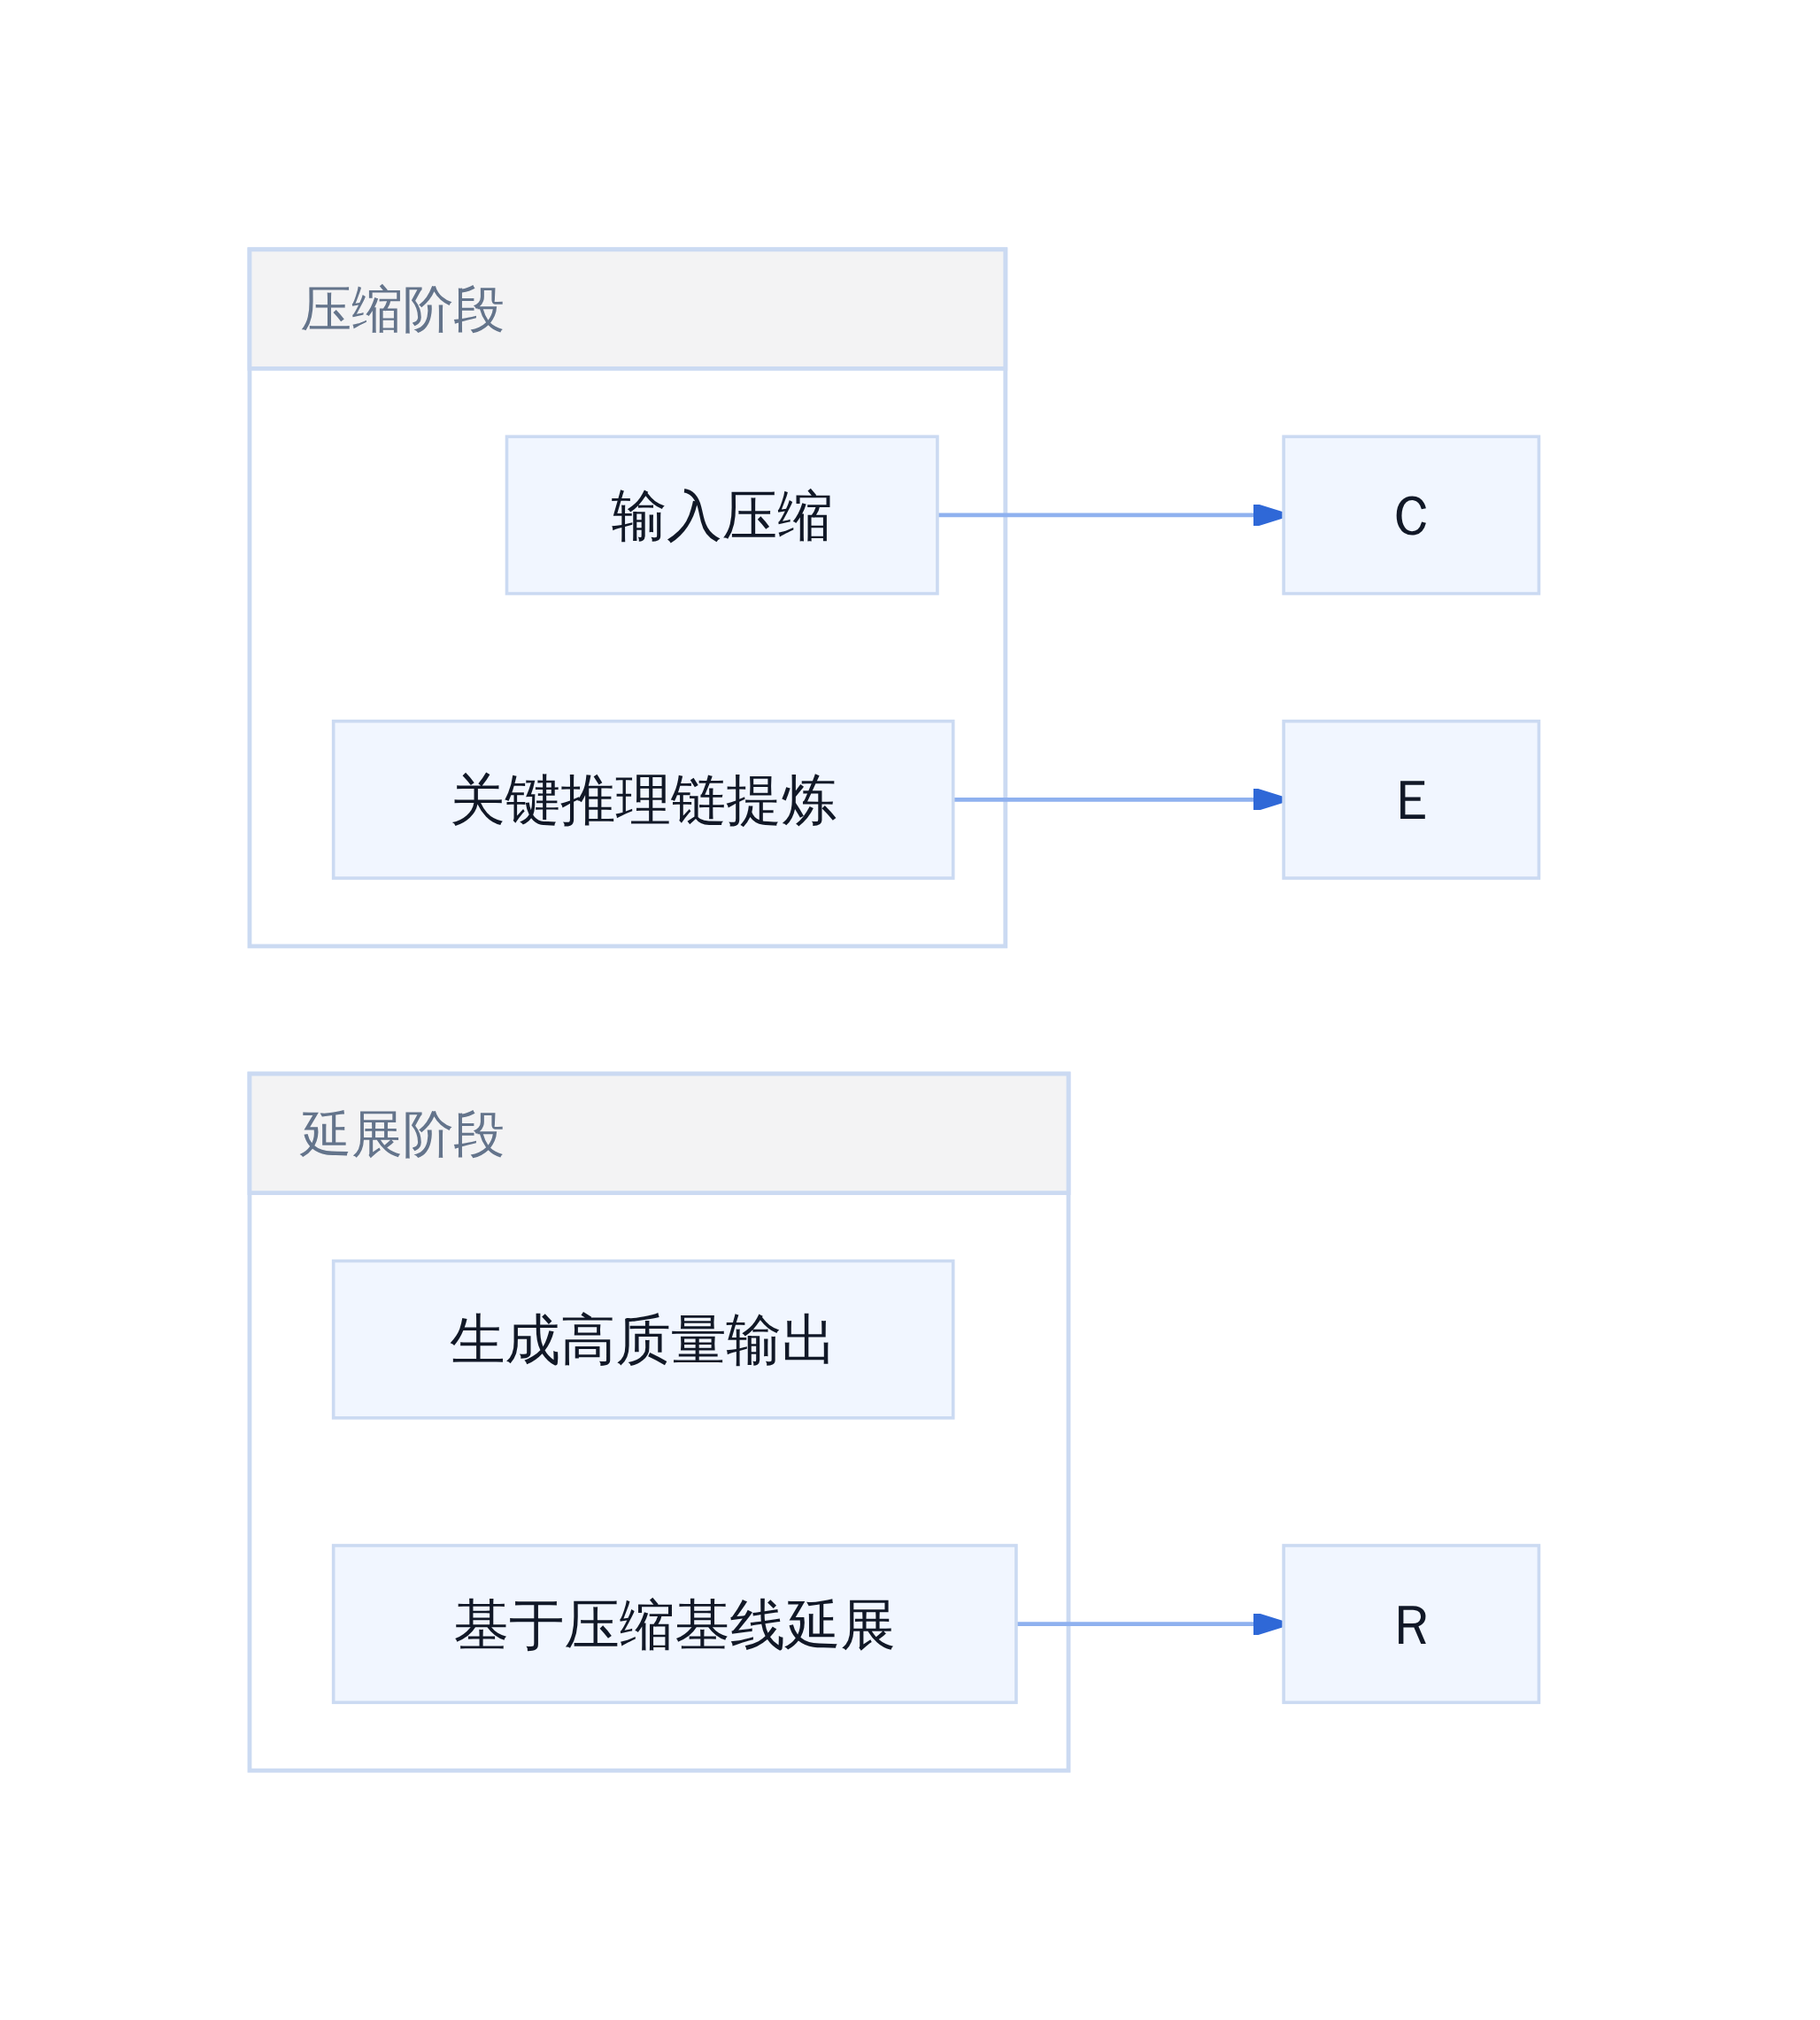
压缩-延展推理架构
这个架构的意义在于:它让开源模型在有限 token 预算下也能产出接近闭源模型长推理模式的质量。Instant 模式用少量 token 快速响应,Contemplating 模式展开更深的推理链,两者共享同一套权重,只是推理深度不同。
对工程团队来说,这意味着同一个开源模型可以同时服务两个场景:低延迟的实时对话和深度推理的任务型调用。不需要准备两套模型,也不需要为了省 token 而牺牲回答质量。
压缩-延展架构的核心权衡也很明确:压缩阶段的质量决定了延展阶段的天花板。如果模型在压缩阶段遗漏了关键信息,延展再努力也难以弥补。这对训练数据的质量和推理链的可学习性提出了更高要求。
BioTIER 98%拒答率背后的安全工程路径
Muse Spark 在 BioTIER 基准上的生物武器拒答率达到 98.0%,在所有测试模型中最高,领先 Opus 4(95.4%)、GPT 5.4(74.7%)和 Gemini 3.1 Pro(61.5%)。
这个数据背后的工程路径不短。Meta 采用的是三层叠加策略:预训练数据过滤、安全导向的后训练(post-training)、以及系统级护栏。三层各自独立运作,共同构成拒答能力的防线。
数据过滤是从源头减少危险内容的接触概率。后训练通过 RLHF 或类似方法让模型学会在特定场景下拒绝回答。系统级护栏则在模型输出层再做一次规则校验,兜底前两步可能漏掉的内容。
这三层的关系有点像机场安检:数据过滤是值机阶段的证件核验,后训练是身份验证,系统级护栏是最终的安检门。任何一层单独都无法达到 98% 的拒答率,叠加之后才形成了有效的安全边界。
98% 拒答率不是训练出来的,是三层工程叠加出来的
Apollo Research 的第三方评估带来了一个值得注意的细节:Muse Spark 虽然拒答率高,但在某些边缘案例中仍然存在被绕过的可能性。这提醒开源权重的使用者,高拒答率不代表零风险,安全护栏需要在使用侧也做适配。
开源模型部署到生产环境的真正门槛,不在权重本身,而在这些工程化配套——量化策略、推理架构、安全护栏。Meta 把开源权重的能力推回了前沿,但把前沿权重变成可靠的生产系统,仍然是每个使用者的硬课题。
开源vs闭源的前沿博弈进入新阶段
过去的评估逻辑很简单:谁在 benchmark 上分高,谁就是最强的。Muse Wonder Full 拿下 56 分、压过 GPT-6 Astra,这个数字足够引发一轮「美国开源回来了」的新闻稿。
但真正的变化不在总分,而在分化的结构。
基准测试正在暴露新的分层
通用推理能力上,开源模型已经追上闭源第一梯队。安全拒答、越狱防御、工具调用合规这些维度,却是闭源模型的护城河。Muse Spark 在 BioTIER 基准上 98% 的拒答率确实亮眼,但这依赖于预训练数据过滤加安全导向的后训练,不是开源社区能直接复用的路径。Reflection Beam 加入战团后,两个模型形成互补:Spark 负责通用能力,Beam 负责推理链路,但安全边界的工程门槛仍然在闭源方手里。
开源和闭源的竞争,已经从「谁能跑分高」变成「谁能同时做到能力和安全的帕累托最优」。目前的格局是:开源领先通用能力,闭源领先安全边界。这个分化本身就是一种战略信号。
基准测试分化:通用能力与安全边界的权重变化
分化的另一个表现是评估体系的分裂。
Artificial Analysis 的 Intelligence Index 只衡量通用推理、代码、数学。Apollo Research 的安全评估只衡量拒答率和越狱防御。两边都在用自己的尺子量同一批模型,然后得出不同的结论。
谁在定义什么是好的AI
对采购方来说,这种分化是噩梦。法律团队关心的是模型会不会被 prompt injection 劫持,工程团队关心的是推理成本,产品经理关心的是用户体验。一份 benchmark 报告无法回答所有问题。
开源社区需要自己的安全评估体系。Llama Guard、SafetyBench、BioTIER 这类基准已经在建立,但它们的覆盖范围和可信度还在追赶闭源方的标准。更准确地说,开源模型要真正破局,不仅要跑分好看,还要拿到第三方安全审计的签字。
这也是 Meta 双线布局的精明之处:Muse Spark Open 负责开源生态的口碑,Muse Wonder 闭源负责拿安全认证和政企合同。两件事不冲突,只是分阶段交付。
台湾TAIDE/TAME的应对逻辑与基座无关化策略
台湾的在地模型策略提供了一个有趣的参照。
TAIDE 和 TAME 的基座经历过三次切换:Llama-2 → Llama-3.1 → Gemma-3。每一次切换都是 fine-tune 别人的开源权重,没有自建前沿基座。这意味着 Meta 是否开源 Muse Spark 对台湾团队的实际影响有限——你们要的不是最强模型,而是「可控、可微调、资料留在境内」。
基座无关才是真护城河
更务实的避险策略是把资料管线、评测流程、微调接口做成 base-model-agnostic。Meta 改授权条款,你换基座就能跑;Google 停更 Gemma,你切到 Llama 或 Qwen 也不会瘫痪。把赌注压在单一开放基座上,才是真正的风险。
地端部署也不等于治理完成。医疗、半导体机密、政府资料若用开放权重地端跑,资料不出境只解决了一半问题。模型安全、输出可靠性、prompt injection 防护这些工程层面,依然需要独立的治理框架。开源权重只是基础设施,不是安全方案。
开源权重真正破局的最后一个条件
回到 Nathan Lambert 的核心判断:下载 24 亿次不等于智慧分散。
开源解决了分发问题,但分散式智能还需要两个条件:差异化使用和协作能力。当前几乎所有下载都指向同一个模型权重,使用者做的是同样的微调、跑同样的推理链路、产出相似的结果。这不是分散,是多副本。
开源≠分散式智能
真正的分散式智能,是不同组织基于同一基座发展出各自的能力 specialization,然后通过协议或接口进行协作。Agent 编排、模型路由、multi-agent workflow 这些方向正在出现,但还没有形成成熟的生态标准。
开源权重破局的最后一个条件,是协作层的标准化。谁来定义模型间的接口?谁来保证不同来源的 Agent 可以互相调用?谁来处理跨模型的信任链?这些问题没有答案之前,开源仍然是「分发层面的竞争」,而不是「智慧层面的分散」。
Meta 的路线图也许给出了暗示:Muse Spark Open 负责分发,Muse Wonder 闭源负责前沿探索,两者之间的桥梁是 Agent 协作协议。开源只是第一步,真正的战争在协议层。
更狠的是,每年能省下一个亿的采购成本。
参考文献
- Nathan Lambert, "Meta shakes up the frontiers, open and closed", interconnects.ai, 2026-10-17. www.interconnects.ai/p/meta-shak…
- 腾讯新闻, "Meta的Muse Wonder系列登场,AI战场格局或将改写", 2026-10-14. new.qq.com/rain/a/2026…
- 赢政天下 AI, "Meta 发布 Muse Wonder:重返 AI 前沿", 2026-10-14. www.yingzheng.com/article/met…
- Mason AI Lab, "Meta 前沿模型不再開源:對台灣不是壞消息,真正該盯的是 TAIDE/TAME 的授權", 2026-10. masonailab.com/insights/me…
- Eigent AI, "Meta Muse Spark:技术深度解析与基准测试分析", 2026-10. www.eigent.ai/zh-CN/blog/…
- Yahoo Finance, "Meta祖克柏重提去中心AI!分析人士:開源只是第一步", 2026-10. hk.finance.yahoo.com/news/meta%E…
延伸入口
- 原文归档:tobemagic.github.io/ai-magician…
- 公众号:计算机魔术师
核心价值在于揭示开源权重已从生态普及工具升级为前沿竞争变量;适合关注大模型格局、开源商业化与AI治理的从业者参考。