很多团队的前端错误监控,停留在一个看似合理、实际却难以行动的状态:平台每天收到成千上万条 TypeError、资源加载失败和接口异常;研发知道“线上有问题”,却很难回答几个真正决定处置效率的问题:
- 这个堆栈究竟对应哪一份生产代码?
- 它是本次发布引入的,还是历史遗留问题?
- 影响的是少量偶发用户,还是关键链路上的大量会话?
- 应该由页面、组件、基础设施、后端接口,还是第三方依赖负责处理?
- 修复上线后,如何证明问题真的消失,而不是被流量变化掩盖?
因此,错误治理不应被理解为“接入一个监控 SDK”,而应被设计成一条生产证据链:把一个运行时症状,稳定地连接到对应的制品、变更与处置责任。
本文采取厂商无关的角度,聚焦浏览器客户端。SSR、Node.js 与 BFF 的异常可以复用同一套发布身份和关联原则,但不在本文展开其服务端采集实现。
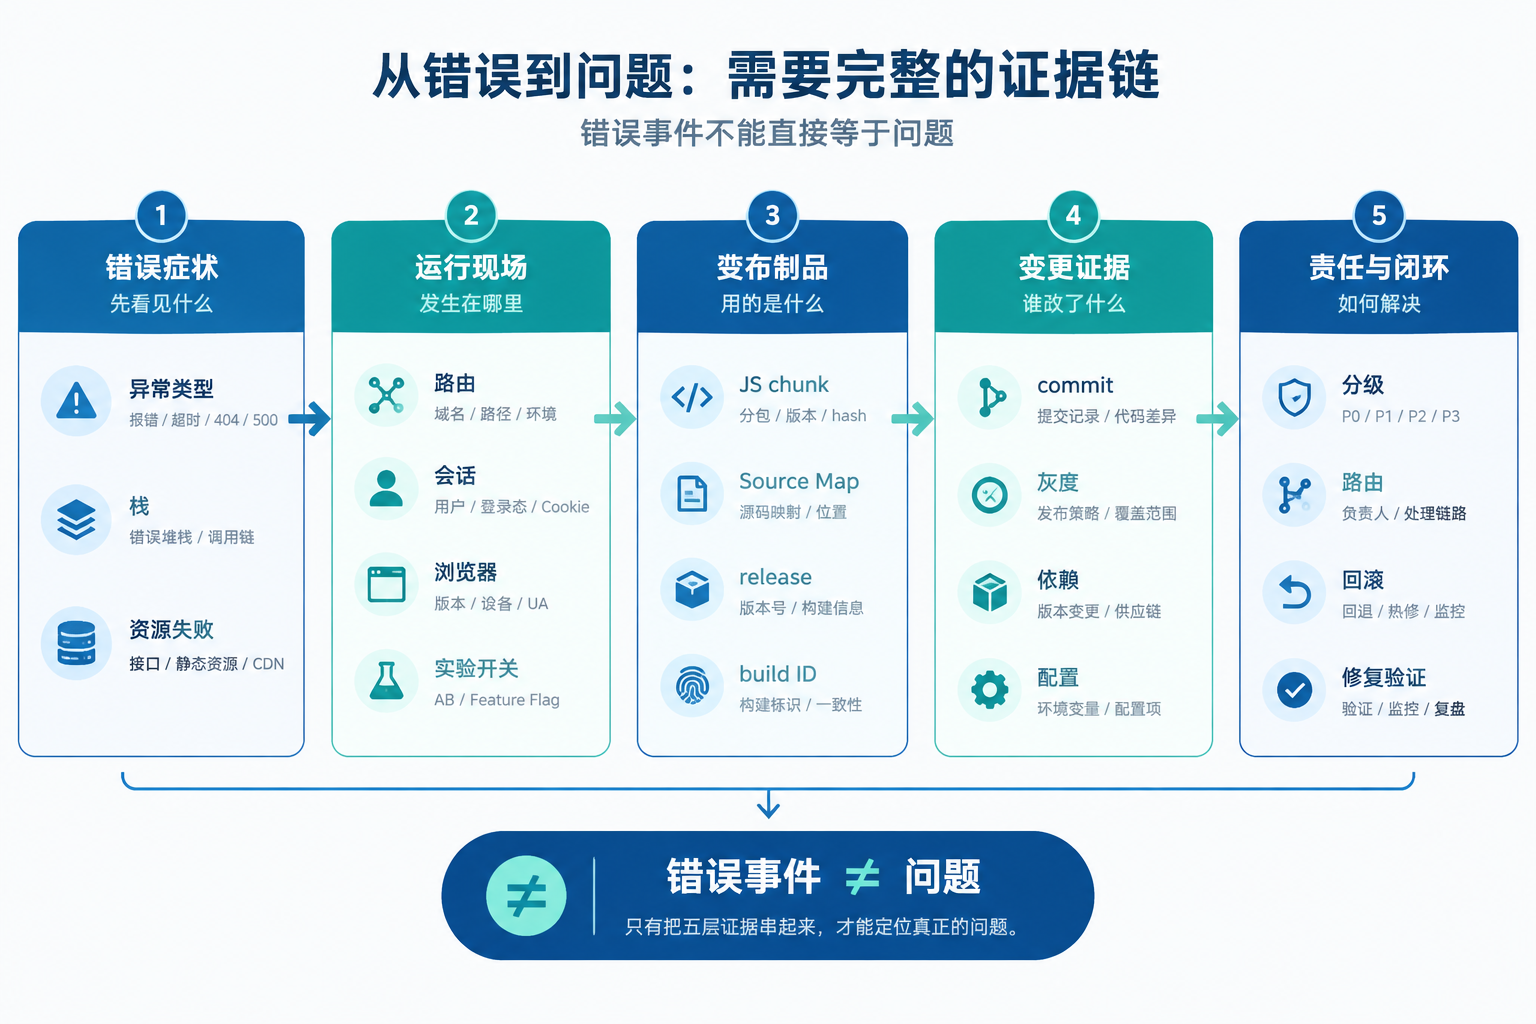
一、从“报错收集”转向“可裁决的证据链”
一条错误事件本身只是症状。比如:
TypeError: Cannot read properties of undefined (reading 'price')
它最多说明某次执行访问了不存在的数据,却不能自动说明:是代码空值判断遗漏、接口返回字段变化、实验开关切换、浏览器兼容性问题,还是某个旧版本仍被 CDN 缓存命中。
要让错误成为可处置的问题,建议把事件沿五层证据组织:
| 证据层 | 要回答的问题 | 典型信息 |
|---|---|---|
| 症状 | 发生了什么? | 异常类型、消息、原始栈、资源 URL、HTTP 状态 |
| 现场 | 在什么使用条件下发生? | 路由、业务动作、面包屑、会话、浏览器、实验开关 |
| 制品 | 当时运行的是哪份代码? | 应用名、环境、release、commit、build ID、chunk 标识 |
| 变更 | 哪次发布或依赖变化最可疑? | 首发版本、部署批次、灰度范围、依赖升级、配置变更 |
| 责任 | 谁应止血、修复并验证? | 组件/领域归属、优先级、工单、回滚或开关策略 |
这五层不是一份大而全的日志字段清单,而是一个约束:没有制品身份的堆栈不能可靠归因;没有用户影响的事件量不能可靠排序;没有版本维度的修复不能可靠关闭。
二、先区分错误类型,再设计采集入口
“前端报错”不是单一事件。不同错误在浏览器中的触发机制、可获得字段和恢复手段都不同。若把它们都塞进同一类 error 事件,后续聚类和归因会天然失真。
1. 同步 JavaScript 异常:全局 error 的主要对象
同步脚本执行、初始加载阶段或事件处理器中未捕获的异常,通常会触发 window 的 error 事件。通过 window.onerror 可以拿到消息、脚本 URL、行列号和错误对象;通过 addEventListener('error', handler) 则接收事件对象。两种接口的参数形态并不相同,采集层应统一转换为内部事件模型,而不是让下游直接依赖浏览器回调参数。 MDN:Window error event
<span>window</span>.<span>addEventListener</span>(<span>'error'</span>, <span>(<span>event</span>) =></span> {
  <span>if</span> (event <span>instanceof</span> <span>ErrorEvent</span> && event.<span>error</span>) {
    <span>reportRuntimeError</span>({
      <span>kind</span>: <span>'runtime'</span>,
      <span>error</span>: event.<span>error</span>,
      <span>source</span>: event.<span>filename</span>,
      <span>line</span>: event.<span>lineno</span>,
      <span>column</span>: event.<span>colno</span>,
    })
  }
})
这里的关键不是“捕获到了”,而是保留 kind: 'runtime'。它决定后续应优先看代码栈、Source Map、首发版本和调用链,而不是把它与图片加载失败混在同一个问题组中。
2. 未处理的 Promise 拒绝:独立记录 unhandledrejection
Promise 被拒绝且没有拒绝处理器时,浏览器会触发 unhandledrejection;async 函数内部未捕获的 throw 也常由这条路径暴露。它不应被伪装成同步 error,因为其 reason 可能不是标准 Error,并且跨域脚本来源的 Promise rejection 可能不会触发该事件,以避免数据泄露。 MDN:Window unhandledrejection event
<span>window</span>.<span>addEventListener</span>(<span>'unhandledrejection'</span>, <span>(<span>event</span>) =></span> {
  <span>reportRuntimeError</span>({
    <span>kind</span>: <span>'unhandled_rejection'</span>,
    <span>error</span>: <span>normalizeUnknownError</span>(event.<span>reason</span>),
  })
})
normalizeUnknownError 的职责是把字符串、普通对象、DOMException 与 Error 规范化,但必须保留原始类型标记。否则一个业务代码 throw 'invalid coupon' 和一个真正的 TypeError 会被错误地放进同一种分析路径。
3. 资源加载失败:需要捕获阶段监听,但通常没有栈
图片、样式、脚本等资源的加载失败也会产生 error,但这类事件常常只是普通 Event,没有 message、error 或 stack。应在捕获阶段监听,并从目标元素提取资源类型与地址:
<span>window</span>.<span>addEventListener</span>(
  <span>'error'</span>,
  <span>(<span>event</span>) =></span> {
    <span>const</span> target = event.<span>target</span>
    <span>if</span> (!(target <span>instanceof</span> <span>HTMLScriptElement</span> ||
          target <span>instanceof</span> <span>HTMLLinkElement</span> ||
          target <span>instanceof</span> <span>HTMLImageElement</span>)) <span>return</span>

    <span>reportResourceError</span>({
      <span>kind</span>: <span>'resource_load'</span>,
      <span>resourceType</span>: target.<span>tagName</span>.<span>toLowerCase</span>(),
      <span>url</span>: target.<span>src</span> || target.<span>href</span>,
    })
  },
  <span>true</span>,
)
资源错误的调查重点通常是 CDN、缓存、网络、内容安全策略、部署清单或动态 chunk 路径,而不是业务源码。因此,资源错误至少要记录:资源 URL 去查询参数后的规范化值、元素类型、当前路由、release、网络状态摘要与是否为动态加载资源。
4. 框架错误边界:用于局部降级,不是全局捕获替代品
以 React 为例,Error Boundary 适合把局部渲染失败转化为可控降级界面,并补充组件树、业务模块和 fallback 状态等高价值上下文;但它并不覆盖所有情形,例如事件处理器、异步回调和服务端渲染错误需要其他路径处理。React 也明确强调渲染期错误不能依赖普通 try/catch 包住 JSX 来捕获。 React:Error Boundaries
工程上更稳妥的模型是三路汇聚:
- 框架边界:记录渲染区域、组件归属与降级是否成功;
- 全局运行时:兜住未捕获同步异常和未处理拒绝;
- 显式业务错误:对可预期失败,如库存不足、权限拒绝、接口契约不满足,使用有业务语义的事件类型上报。
三路汇聚后必须有去重机制。一个组件渲染异常可能同时进入边界回调和全局异常监听;应利用短时间窗口、标准化栈、错误对象标识或内部事件 ID 标注父子关系,避免把同一次故障放大为两三个问题。
5. 跨域脚本:错误信息缺失首先是部署协议问题
当脚本跨域加载却没有正确配置 crossorigin 与服务端 CORS 响应时,window.onerror 对错误日志的访问会受限。换言之,第三方 SDK、独立 CDN、动态远程模块的“只有模糊错误消息”并不只是监控工具能力不足,而是资源交付协议没有为可观测性提供足够权限。 MDN:crossorigin attribute
对自有跨域脚本,应将以下规则固化到发布基线:
<script>使用与资源策略匹配的crossorigin配置;- CDN 返回相应的 CORS 响应头;
- 对第三方不可控脚本,单独标记
ownership: third_party,不要把信息缺失误判为“无可归因价值”; - 远程模块加载失败时,同时记录宿主 release、远程应用 release、远程入口 URL 与模块名。
三、统一事件模型:让字段各司其职
错误平台最常见的失败模式,是把所有能拿到的信息都放入 tags。结果是索引基数爆炸、检索变慢、分组漂移,也扩大了隐私泄露面。
建议把字段分成五类。
1. 身份与时间:每条事件必须有
<span>{</span>
  <span>"event.id"</span><span>:</span> <span>"uuid"</span><span>,</span>
  <span>"event.time"</span><span>:</span> <span>"2026-09-14T10:12:03.456Z"</span><span>,</span>
  <span>"event.kind"</span><span>:</span> <span>"runtime | unhandled_rejection | resource_load | business"</span><span>,</span>
  <span>"app.name"</span><span>:</span> <span>"checkout-web"</span><span>,</span>
  <span>"deployment.environment"</span><span>:</span> <span>"production"</span><span>,</span>
  <span>"release"</span><span>:</span> <span>"checkout-web@2026.09.14+9f3a1c2"</span><span>,</span>
  <span>"app.build_id"</span><span>:</span> <span>"build-01J7..."</span>
<span>}</span>
其中 release 是人类可识别的发布版本,app.build_id 是构建制品的唯一标识。二者不要互相替代:前者适合按版本分析与回滚,后者适合精确匹配 Source Map、chunk 和构建记录。OpenTelemetry 的应用事件语义也将 exception.type、exception.message、exception.stacktrace、service.version、app.build_id 与 session.id 分别视为具有不同用途的关联信息。 OpenTelemetry:App Events
2. 聚类字段:必须稳定、低噪声
适合参与 fingerprint 的通常是:
- 规范化后的异常类型;
- 去动态值后的消息模板;
- 符号化后的前 1~3 个自有代码关键栈帧;
- 错误类别,例如
resource_load或api_contract。
不适合直接参与 fingerprint 的包括订单号、用户输入、时间戳、随机 ID、完整 URL 查询参数和请求 trace ID。它们会让同一个代码缺陷裂成大量问题组。
3. 现场上下文:用于判断影响与触发条件
建议保留:路由模板、页面动作名、匿名会话 ID、浏览器主版本、设备类别、实验开关摘要、最近 N 条脱敏面包屑,以及 API 的方法、路径模板、状态码和错误码。
不要把完整请求体、响应体、Cookie、Authorization 头或原始用户资料作为“上下文”上传。OWASP 建议日志记录足够分析所需的时间、位置、主体和事件信息,同时明确不应直接记录访问令牌、会话标识、密码、敏感个人信息、密钥和应用源码;需要会话关联时,可使用加盐哈希或去标识化值。 OWASP:Logging Cheat Sheet
4. 索引字段与附件字段:区分查询成本
适合索引的字段应少而稳定,例如:app.name、environment、release、error.kind、fingerprint、路由模板、浏览器主版本、严重度。
体积较大或高基数的信息,如完整 stack、网络请求摘要、面包屑序列、组件树、屏幕截图,应放在事件详情或附件存储中,并设置长度、采样和保留期限。不要为了“以后也许有用”而让每条错误带上全部调试日志。
5. 关联字段:把前端错误放回完整链路
如果系统已有 RUM、API 网关日志或后端 trace,应优先复用可控的关联 ID:
session.id:判断受影响用户与会话失败率;trace.id或请求关联 ID:关联某次 API 调用;deployment.batch:判断灰度批次;feature.flag_set的摘要:判断实验相关性;module.name与module.release:定位微前端或远程模块。
关联并不意味着把所有系统的数据复制进错误平台;它意味着保留能跳转或查询的最小证据。
四、Source Map 的本质:生成位置到源代码位置的制品证据
Source Map 经常被误解成“把源码上传到错误平台”。更准确地说,它是一个描述映射关系的 JSON 文档:生成后的文件位置如何回到原始源文件、行列和符号名。
ECMA-426 规范中,sources 表示原始输入源列表,sourcesContent 可选地携带原始内容,names 保存可供映射引用的符号名,mappings 编码生成代码位置与原始位置之间的对应关系,file 可标明关联的生成文件。它服务于源码级调试和服务端栈反混淆,而不等同于一份简单的源码副本。 ECMA-426:Source Map Format
映射成立的前提:必须命中同一份生成制品
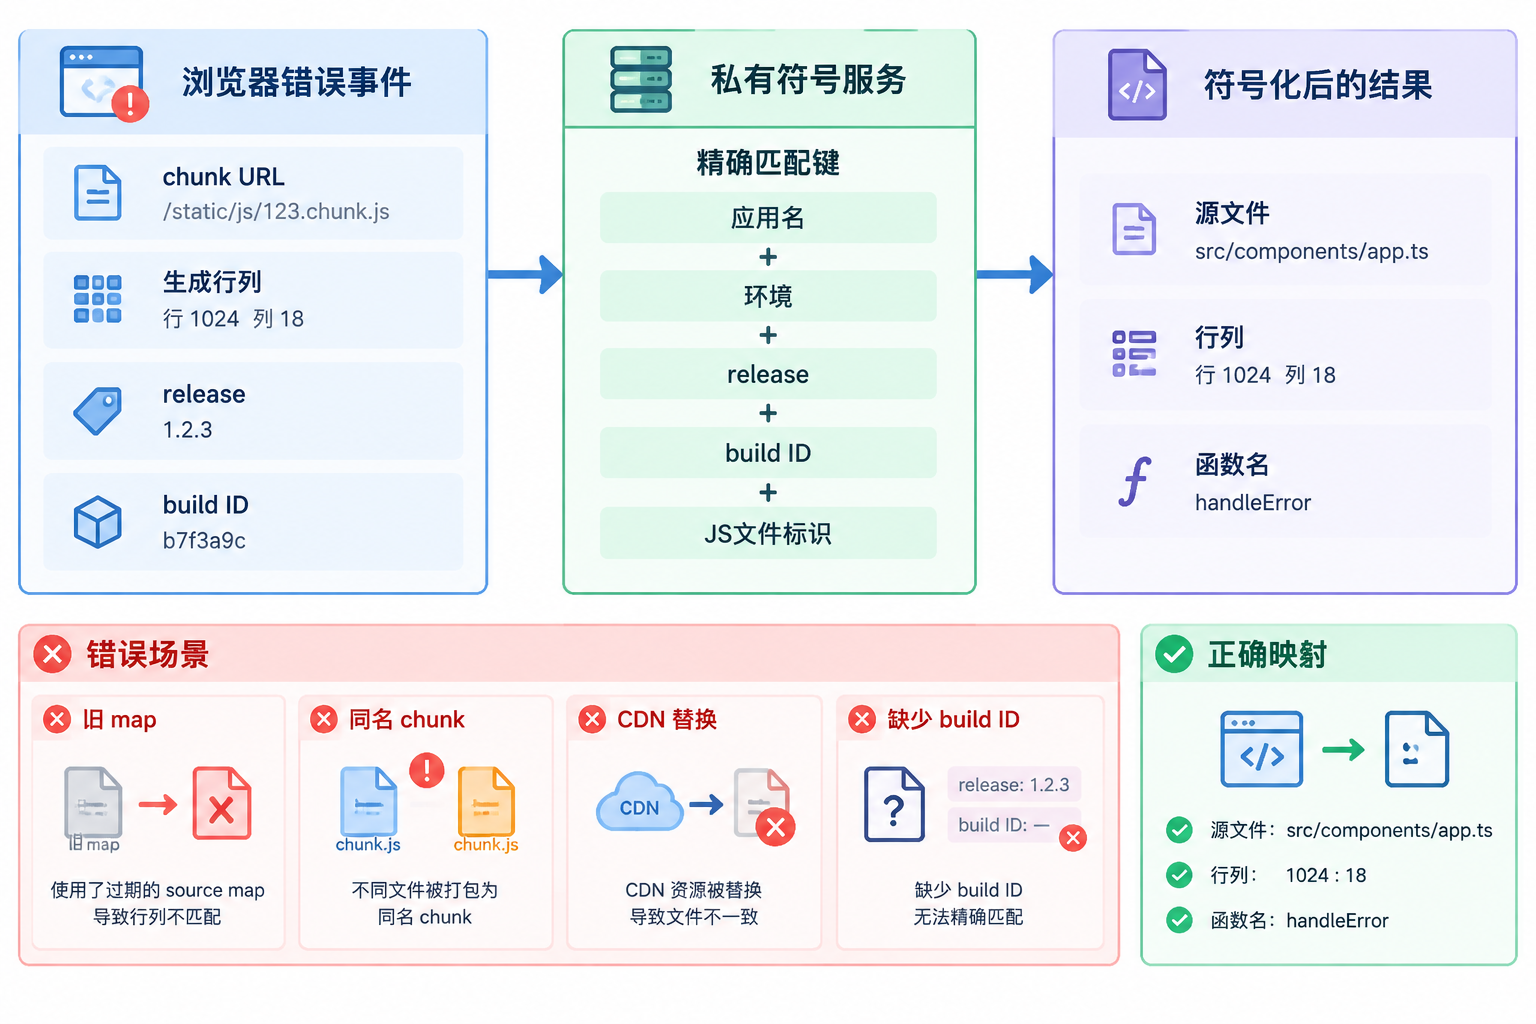
假设线上栈帧是:
https://cdn.example.com/assets/cart-D7k2a.js:1:48291
错误平台要还原到 src/cart/price.ts:42:11,至少需要同时确认:
- 栈中的 JS 文件确实是
cart-D7k2a.js; - 行列号对应的是该文件未经替换的字节内容;
- 上传的 map 正是这个 JS 文件构建时生成的 map;
- map 所属应用、release、build ID 与错误事件一致;
- 错误平台能够定位到该 map,而不是同名旧文件或另一应用的制品。
任何一个条件不成立,符号化都可能失败,或者更危险地映射到看似合理、实际错误的源代码位置。
Hash、代码分割与缓存为什么容易破坏映射
生产构建通常包含内容 hash、动态 import 和 CDN 缓存,这些优化本身没有问题;问题在于团队只上传 map,却没有把 map 与产物身份绑定。
典型故障包括:
- 部署后 JS 被 CDN 回源替换,但错误平台仍保存上一轮同名 map;
- 某个动态 chunk 因灰度或缓存滞留而来自旧 release,页面主包却来自新 release;
- 构建后又对 JS 做二次压缩、注入或重写,却没有重新生成 map;
- 多个子应用输出相同 chunk 名称,符号服务只按文件名查找;
- map 上传成功被误当作映射可用,实际上上传文件缺失、release 写错或 build ID 不一致。
因此,Source Map 的正确治理单位不是“一个 .map 文件”,而是:
应用 + 环境 + release + build ID + 生成 JS 的精确文件标识 + map
五、把 Source Map 放进受控发布流水线
生产 Source Map 应被视为私有调试制品,而不是静态站点附件。
webpack 文档指出,hidden-source-map 不会在 bundle 中写入 Source Map 引用,适合仅用于错误报告;同时明确建议不要把 map 文件部署到普通 Web 服务器。即使使用不含 sourcesContent 的 nosources-source-map,文件名和工程结构仍可能暴露。 webpack:Devtool
Vite 的 build.sourcemap: 'hidden' 也只是抑制 bundle 内的 sourcemap 注释;它不等于 map 自动私有。只要 .map 仍被同步上传到可公开访问的 CDN 路径,访问控制风险依然存在。 Vite:Build Options
一条可靠的流水线至少应包含以下步骤:
构建生成 JS 与 map
        ↓
为本次构建生成 release / build ID / commit 元数据
        ↓
校验每个 JS 与 map 的配对关系和完整性
        ↓
上传 map 到私有符号服务,并绑定应用与制品身份
        ↓
仅部署 JS、CSS、静态资源到公开 CDN
        ↓
部署后用真实栈帧或抽样事件验证反混淆结果
        ↓
按权限、保留期和审计策略管理 map
发布校验不应只检查“上传接口返回 200”
建议在 CI 中设置四类失败条件:
- 覆盖率失败:入口和所有异步 chunk 中存在未找到 map 的 JS;
- 身份失败:map、错误 SDK 注入的 release/build ID、部署清单三者不一致;
- 可用性失败:用构建产物中的若干生成位置反查,无法得到预期源文件与行列;
- 暴露失败:公开 CDN 或静态站点可以直接访问
.map文件。
最后一项尤其重要:hidden 只是“不在 JS 文件中声明地图地址”,不是“地图不可访问”。
多应用与微前端:不要让宿主替子应用背锅
单体 SPA 可以把 app.name + release + build_id 视为一组身份;多应用或微前端必须拆开记录:
| 场景 | 事件必须附带的身份 |
|---|---|
| 宿主应用渲染异常 | host app、host release、host build ID |
| 子应用自身代码异常 | sub-app、sub-app release、sub-app build ID |
| 模块联邦远程加载失败 | host identity、remote name、remote entry URL、remote release(若可得) |
| 共享依赖异常 | 触发模块身份、共享依赖版本、最终生成 chunk 标识 |
原则很简单:谁产出了执行中的字节码,谁就必须能被制品身份定位。 宿主可以补充页面和导航现场,但不应把远程模块错误统一标成宿主 release。
六、从“同一个错误很多条”收敛为“一个可处理问题”
错误事件和问题不是一一对应关系。
- 同一个空值缺陷,可能在数万次会话中产生数万条事件;
- 同一句“Network Error”,可能来自 DNS、超时、鉴权失效和浏览器扩展拦截;
- 同一个压缩后的栈,可能因 Source Map 缺失而把多个源问题错误合并。
因此,问题分组要在符号化之后尽可能使用稳定证据。
一个实用的 fingerprint 结构
fingerprint = hash(
  error.kind,
  normalized exception.type,
  normalized message template,
  top owned stack frames,
  optional business domain
)
其中:
normalized message template应删除订单号、UUID、时间、用户输入等动态片段;top owned stack frames只保留自有代码的关键帧,第三方库帧可作为辅助信息;business domain仅在确有必要时加入,例如同一基础异常在“支付确认”和“商品推荐”两个领域必须分派给不同团队。
两种常见的分组错误
过度拆分:把完整 URL、请求 ID、用户 ID 放进分组键。结果是每个用户、每次请求都变成新问题,告警与工单失去收敛能力。
过度合并:只按异常消息分组。例如所有 Failed to fetch 都归为一个问题,最终既无法判断是后端 500、跨域、离线还是第三方域名故障,也无法分派责任。
更好的做法是把“稳定的代码症状”放进 fingerprint,把浏览器、路由、请求状态、实验开关和用户影响放到问题的分布维度中。前者决定“是不是同一个问题”,后者决定“为什么现在值得处理”。
七、归因不是找最后一帧,而是比较证据
Source Map 能回答“异常落在什么源文件”,却不能自动回答“为什么发生”。把责任简单归给最后一个栈帧,容易把数据问题、第三方故障或兼容性问题误判为开发者编码失误。
建议将归因设计为一个由证据驱动的决策过程。
1. 先判断是否与变更强相关
优先检查:
- 错误首次出现的时间是否紧跟某个 release;
- 新 release 的错误率是否显著高于旧 release;
- 是否只集中在一个灰度批次、地区或租户;
- 是否与某次依赖升级、配置发布、特性开关启用同步发生。
如果错误只在 release A 出现,而 release B 没有,且两者面对相近曝光量,那么代码回归的概率更高。反之,如果所有 release 同步增加,应先看接口、CDN、身份服务或第三方依赖。
2. 再比较共同现场
把同一问题按下列维度切分观察:
- 路由模板与业务动作;
- 浏览器内核和主版本;
- 操作系统、设备类别、网络状态;
- 实验开关组合;
- API 状态码、后端错误码、关联 trace;
- 是否来自某个远程模块或第三方域名。
例如,某异常只在 Safari 的一个主版本出现,且集中于文件上传动作,应该优先进入兼容性调查;若它只发生在某个实验组,则先暂停开关往往比立即全量回滚更合理。
3. 最后形成可执行的归因结论
归因输出不应该是模糊的“前端问题”,而应是带置信度和下一步动作的结论:
| 归因类型 | 典型证据 | 首选动作 |
|---|---|---|
| 代码回归 | 新版本首发、栈帧集中于改动模块、旧版本正常 | 回滚、热修复、补回归测试 |
| 数据或契约异常 | 栈稳定但输入字段缺失、关联 API 响应异常 | 降级兜底、修复契约、补数据校验 |
| 浏览器兼容性 | 特定浏览器/系统高度集中 | 特性检测、兼容补丁、降级路径 |
| 第三方故障 | 外部域名、SDK 或远程模块失败集中 | 隔离依赖、超时与 fallback、供应商排障 |
| 用户环境噪声 | 极低影响、网络/扩展/定制环境分散 | 规则采样、降噪,不盲目告警 |
这里的“置信度”很重要。证据不足时,应标记为待验证假设,而不是把责任强行派给最后修改代码的人。
八、优先级看影响,不看报错总量
事件量会受流量、重试、循环上报和单个用户反复触发影响,不能直接代表严重程度。
建议以以下因素建立分级:
优先级 = 用户影响 × 关键路径权重 × 不可恢复性 × 持续时间 × 版本覆盖
可执行的判断方式如下:
- 受影响独立用户数:避免一个用户反复触发淹没全局;
- 会话失败率:错误是否阻断完成下单、支付、提交等目标;
- 关键路径权重:发生在登录页和发生在低频设置页,处置优先级不同;
- 可恢复性:刷新、重试、降级是否能恢复;
- 持续时间:短暂发布抖动与持续数小时的系统性故障不同;
- 版本覆盖:只影响 1% 灰度还是已覆盖大部分生产用户。
这样,某个只影响 20 名用户但完全阻断支付的错误,可能应高于一个影响 1,000 名用户但刷新即可恢复的非关键页面异常。
九、治理闭环:问题关闭必须有证据
一个可扩展体系的终点不是“创建了一张工单”,而是形成从发现到验证的闭环:
检测 → 聚类 → 分级 → 路由 → 止血 → 修复 → 发布 → 验证 → 关闭
1. 检测与路由
高严重度、关键路径、突增型问题可以实时告警;低价值或已知噪声不要全部打到值班通道。路由规则应尽量建立在代码归属、业务领域、应用名和模块名之上,而不是依赖人工猜测。
2. 止血优先于完美定位
当影响明确且可快速恢复时,优先使用:
- 发布回滚;
- 特性开关关闭;
- 远程模块降级;
- 接口兼容 fallback;
- 页面局部 Error Boundary 降级。
止血不等于放弃根因分析,而是先缩短用户暴露时间。
3. 修复验证必须按 release 与曝光量进行
“全局报错数下降”不能证明修复有效,因为流量本身可能下降。关闭问题前至少验证:
- 修复 release 已达到预期覆盖范围;
- 该 release 在足够曝光量下,目标 fingerprint 的发生率显著下降或归零;
- 未出现新的相邻 fingerprint,避免修复只是把错误换了一种表现;
- 关键路径成功率、接口失败分布或降级率没有恶化;
- 对应的回归测试、契约校验或发布校验已经补齐。
十、渐进落地:先让证据可信,再追求丰富
不建议一开始就采集所有日志、接入所有告警、构建复杂的 AI 归因。更稳妥的落地顺序是:
阶段一:建立最小可信身份
- 统一
app.name、environment、release、build_id; - 覆盖同步异常、未处理拒绝、资源加载失败;
- 为每类事件保留明确
kind; - 确立脱敏规则和数据保留边界。
阶段二:让 Source Map 可验证
- 构建时生成高质量 map;
- 将 map 私有上传并与 release/build ID 绑定;
- 在 CI 校验 JS 与 map 配对;
- 部署后抽样验证符号化;
- 阻止
.map文件进入公开制品路径。
阶段三:让问题能够收敛与排序
- 建立稳定 fingerprint;
- 补充路由、动作、会话、实验开关和请求摘要;
- 用独立用户、会话失败率和关键路径进行分级;
- 对第三方、资源错误、兼容性错误设置专门的分组与降噪规则。
阶段四:接入组织化处置
- 与发布记录、特性开关、工单和回滚系统建立关联;
- 依据模块归属自动路由;
- 为高风险问题定义止血预案;
- 用 release 维度验证修复并沉淀回归规则。
结语:错误治理的单位不是事件,而是可验证的问题
一个没有 release 的错误栈,只是模糊症状;一份无法匹配生产 JS 的 Source Map,只是不可采信的附件;一个只按事件量排序的告警,只是在放大噪声。
真正可扩展的前端错误治理体系,应把浏览器捕获、框架降级、Source Map、发布元数据、用户影响和处置流程组织成一条连续证据链。这样,团队面对的不再是“线上又有很多红点”,而是能够明确回答:哪份生产制品、在什么条件下、影响了哪些用户、最可能由什么变更引起,以及应该如何验证修复。
文章将前端错误监控升级为可裁决的证据链,尤其适合前端、可观测性与DevOps团队用于发布归因、错误分派和修复验证。