从 Rollout 到权重同步:Mooncake 如何支撑高性能强化学习系统|QCon上海
阅读完需:约 8 分钟
AI Native 架构需重构系统边界与协作范式;Agent Runtime 是生产级智能体的基础设施底座;Loop Engineering 强调人机协同闭环的工程化度量与迭代。
适合 AI 平台工程师、MLOps 工程师、系统架构师阅读。
将于 10 月 22 日—24 日举办,聚焦 Harness AI 时代的工程实践,围绕 AI Native 架构、Agent Runtime、AI Infra、Data Systems、Agent 安全与可观测、Loop Engineering、Vibe Coding、具身智能与世界模型、端云协同等前沿技术方向,邀请全球技术社区与产业一线的实践者,系统性分享前沿洞察与实战经验,共同探索 AI 从能力到系统、从实验到生产的真实路径。
在这一背景下,2026 年 QCon 全球软件开发大会大会 · 上海站正式启动。本次大会将于 10 月 22 日—24 日举办,聚焦 Harness AI 时代的工程实践,围绕 AI Native 架构、Agent Runtime、AI Infra、Data Systems、Agent 安全与可观测、Loop Engineering、Vibe Coding、具身智能与世界模型、端云协同等前沿技术方向,邀请全球技术社区与产业一线的实践者,系统性分享前沿洞察与实战经验,共同探索 AI 从能力到系统、从实验到生产的真实路径。
Mooncake 社区 Maintainer 马腾博士已确认出席 “AI Infra:算力效率决定规模化落地” 专题,并发表题为**《从 Rollout 到权重同步:Mooncake 如何支撑高性能强化学习系统》**的主题分享。强化学习系统的性能瓶颈不仅来自模型训练,也来自 Rollout 数据传输、经验回放和权重同步。Mooncake 面向 RL 场景提供高性能数据面:通过结构化对象、DataProto/typed-ragged、BufferPool 及 RDMA 优化 Rollout 数据流,并接入 Miles 替代 Ray Object Store,支持同步和 Fully Async 两种执行模式。在权重更新方面,Mooncake 同时支持 NCCL Broadcast、TransferEngine P2P RDMA 和 disk-delta,在 Kimi-K2 场景中 P2P 方案约实现 7 倍加速。此外,它还支持 TP/PP/EP/DP 异构 Reshard、Store 权重快照及 MoE 稀疏 Delta,为大规模 RL 训练提供高吞吐、低延迟、可扩展的数据与权重基础设施。在本次演讲中,马腾博士将围绕这些话题展开深入分享。
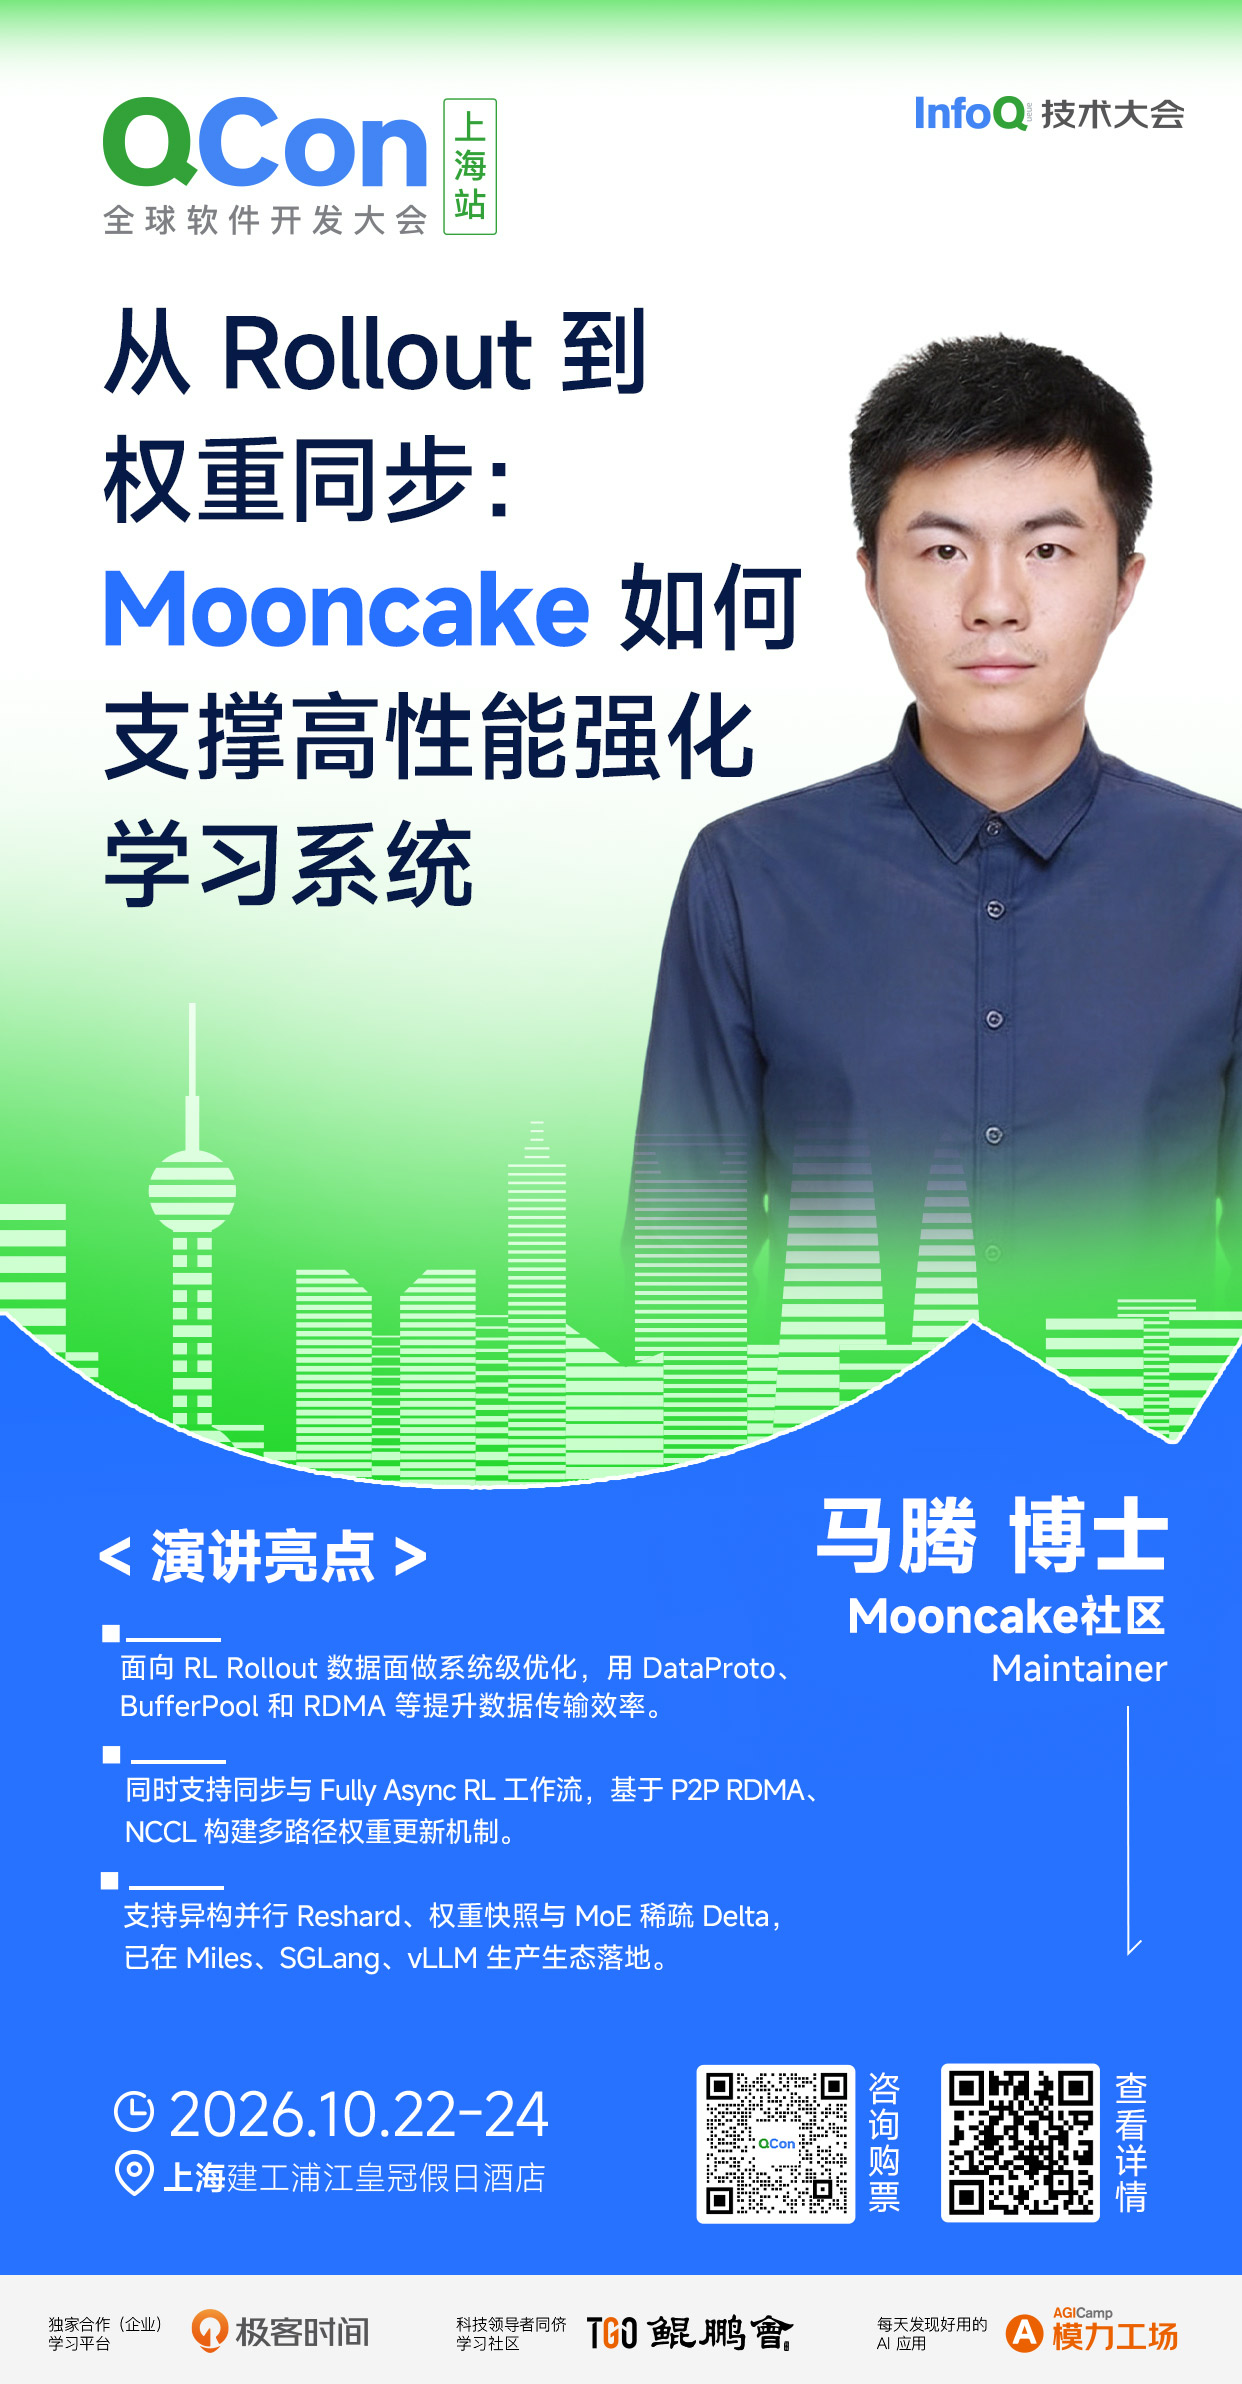
马腾博士是 KVCache 开源项目 Mooncake(6.5K Star)的 Maintainer。目前,Mooncake 已经有阿里云、清华、月之暗面、蚂蚁、字节、小红书、趋境科技等多方参与,并成功接入 vLLM、SGLang、TRT-LLM、Dynamo 等社区。同时,他也是 SGLang、RBG 等社区的 Committer。
他在 SOSP、ASPLOS、ATC、SC、EuroSys、VLDB、TPDS 等顶级会议和期刊上发表论文三十余篇,相关成果获授权美国、中国专利 10 项。他曾入选 CCF 系统软件专委会优秀博士论文激励计划,并担任 PPoPP、FAST、DASFAA、TPDS、ICME、TC、JSC 等国际会议/期刊的程序委员会成员和审稿人。他在本次会议的详细演讲内容如下:
演讲提纲
1. 强化学习系统的整体流程
- Rollout、数据传输、Learner 更新与权重下发
- 同步 RL 与 Fully Async RL 的执行模式
- RL 系统中的数据面与控制面
2. RL 场景面临的系统挑战
- Rollout 数据规模大、结构复杂
- Actor 与 Learner 之间的数据传输开销高
- 权重更新频繁且容易阻塞采样
- 不同并行策略下的权重布局不一致
- MoE 模型权重同步成本高
3. Mooncake 的高性能 RL 数据面
- 结构化对象与 DataProto 数据组织
- typed-ragged 对变长序列数据的支持
- BufferPool 降低内存分配和拷贝开销
- RDMA 加速 Rollout 数据传输
- 接入 Miles 替代 Ray Object Store
4. 同步与 Fully Async Rollout
- 同步 Rollout 的数据流与权重更新流程
- Fully Async 模式下 Actor、Rollout 与 Learner 解耦
- 数据生产、消费和缓存的并行化
- 吞吐、延迟与训练稳定性的权衡
5. Mooncake 的权重更新机制
- NCCL Broadcast:适合高带宽集体通信
- TransferEngine P2P RDMA:实现点对点高效传输
- disk-delta:降低权重更新的数据传输量
- Kimi-K2 场景下 P2P 约实现 7 倍加速
6. 异构并行与大模型支持
- TP、PP、EP、DP 之间的异构 Reshard
- Store 权重快照与快速恢复
- MoE 稀疏 Delta 更新
- 不同集群和硬件拓扑下的权重调度
7. 生态集成与生产实践
- Miles 中的 RL 数据面应用
- 与 SGLang、vLLM 等推理框架协同
- Rollout、训练和权重服务的统一基础设施
- 面向生产环境的稳定性、可观测性与容错
8. 未来发展方向
- 面向 RL 的统一数据对象和传输接口
- 更高效的异步权重同步与版本管理
- 面向 MoE 和超大模型的稀疏更新
- 推动 Mooncake 与更多开源 RL 项目协同优化
实践痛点
- 不同 RL 框架之间的数据结构和接口缺乏统一标准。
- Ray Object Store、网络传输和权重同步容易形成系统瓶颈。
- Fully Async 场景需要处理数据一致性、权重版本和训练稳定性。
- TP/PP/EP/DP 异构 Reshard 适配复杂,跨框架推广成本较高。
- 需要与更多开源项目共同验证性能并完成协同优化。
前沿亮点
- 面向强化学习 Rollout 数据面进行系统级优化
- 通过 DataProto、typed-ragged、BufferPool 和 RDMA 提升数据传输效率。
- 同时支持同步与 Fully Async RL 工作流。
- 基于 P2P RDMA、NCCL 和 disk-delta 构建多路径权重更新机制。
- 支持异构并行 Reshard、权重快照和 MoE 稀疏 Delta。
- 已在 Miles、SGLang、vLLM 等生产生态中得到应用。
听众收益
- 理解大模型强化学习中 Rollout、数据传输和权重同步的关键瓶颈。
- 掌握 Mooncake 在 RL 数据面和权重更新方面的核心能力。
- 了解同步与 Fully Async RL 的系统实现思路。
- 学习如何利用 RDMA、BufferPool 和结构化数据降低传输开销。
- 了解异构并行 Reshard 及 MoE 稀疏权重更新的实践方法。
- 获得将 Mooncake 集成到其他 RL、推理和训练框架中的设计思路。
除此之外,本次大会还策划了Loop Engineering、千行百业 Agent 创新实践、Agent 自主进化:从记忆到持续学习、Agent as a Service、Vibe Coding 时代的新质量债、理性驾驭 AI 的 SRE 可靠性工程、金融 AI Native工程实践:从研发提效到业务破局、AI Infra:算力效率决定规模化落地、AI Native 架构等 20 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 100+资深专家在现场带来前沿技术洞察和一线实践经验。
查看更多详情可扫码或联系票务经理 18514549229 进行咨询。
对做RL训练基础设施的团队很有参考价值:把Rollout数据流与权重同步拆解成可优化的数据面问题,RDMA与稀疏Delta思路可直接借鉴于大规模MoE训练与异步RL落地。